
library(dismodlite)
library(data.table)
#>
#> Attaching package: 'data.table'
#> The following object is masked from 'package:base':
#>
#> %notin%Qué vas a aprender
- Cómo dismodlite pasa de la estimación nacional a las ubicaciones subnacionales (regiones, departamentos, provincias…): qué supone y qué hace en cada paso.
- Los cuatro modos de la estimación subnacional (
covariables,plano,razonyno) y cuándo conviene cada uno. - Qué hacen las covariables y sus valores subnacionales (los proxies), la fuerza del efecto κ y la renormalización.
- Cómo un indicador de encuesta con varias ediciones se convierte en los proxies de una covariable: el gradiente, el paseo aleatorio, el cierre en el valor nacional y cómo leer q.
- Cómo validar el gradiente entre ubicaciones con datos subnacionales reservados (
subnacional.anio_validacion). - Para qué sirve la
escalade una covariable.
El ejemplo es el proyecto sintético del paquete: una enfermedad ficticia, la arteriopatía crónica sintética (causa 9100), en el Perú y sus 25 departamentos. Todo vale igual para cualquier país y cualquier nivel subnacional.
La idea
La estimación de referencia (el ancla, una descarga de GBD Results) y los datos locales que entran al ajuste son nacionales: el ajuste da la prevalencia, la incidencia y la mortalidad en exceso del país, por edad y sexo. Para las ubicaciones subnacionales casi nunca hay una estimación de referencia, así que dismodlite parte del ajuste nacional y supone que cada ubicación comparte la forma de la enfermedad del país y se aparta de él según sus covariables:
-
Diferencias de covariables. Para cada ubicación y cada covariable con valores subnacionales en la tabla
covariables, la diferencia entre el valor de la ubicación y el nacional, en la escala de la transformación de la covariable. -
Desplazamiento de las tasas. La incidencia (log i) o la mortalidad en exceso (log f) nacional se mueve, en cada edad, en β × diferencia × κ, con la β publicada de la covariable (tabla
betas). - Nueva solución del modelo. Con las tasas desplazadas se vuelve a resolver la ecuación del modelo en cada ubicación: sale su prevalencia por edad.
- Renormalización. Los casos de todas las ubicaciones se escalan para que sumen los casos nacionales.
Todo se hace simulación por simulación, así que la incertidumbre del ajuste nacional, la de las covariables y la de las β llegan a las estimaciones subnacionales.
Los cuatro modos
La clave subnacional.modo de la configuración elige el modo. Sin ella, el paquete lo deduce de las tablas del proyecto:
subnacional.modo |
Qué hace | Qué necesita | Por defecto si… |
|---|---|---|---|
covariables |
Desplaza las tasas nacionales según las covariables de cada ubicación (los pasos de arriba). | La tabla betas y, en la tabla covariables, el valor nacional de cada covariable y sus valores subnacionales. |
alguna covariable de betas tiene filas subnacionales en covariables. |
plano |
Cada ubicación recibe las tasas nacionales; sus casos difieren solo por su población. | Ubicaciones subnacionales en ubicaciones y poblacion. |
no hay proxies, pero la población trae ubicaciones subnacionales. |
razon |
Cada ubicación recibe las tasas nacionales por su razón (la tasa de la ubicación entre la nacional), con cierre en el valor nacional. | La tabla razones, con la razón de cada ubicación subnacional en el año que se estima, y ninguna covariable con valores subnacionales. |
nunca: se declara. |
no |
Solo la estimación nacional. | Nada más. | la población trae solo la ubicación nacional. |
El ejemplo: modo covariables
La configuración de la causa 9100 declara el año de los datos reservados para validar:
cat(readLines(dl_ejemplo("config", "9100.yaml"), encoding = "UTF-8"), sep = "\n")
#> # Arteriopatía crónica sintética (causa 9100): configuración de ejemplo con datos sintéticos.
#> # Las claves que no aparecen toman su valor por defecto: ver ?dl_configuracion y print(dl_proyecto(...)).
#> causa: 9100
#> nombre: Arteriopatía crónica sintética
#> anio: 2023
#> edad_inicio: 30
#>
#> mortalidad_exceso:
#>   techo: 0.25                  # por persona-año
#>
#> subnacional:
#>   anio_validacion: 2019          # año de los datos subnacionales reservados para validar
#>
#> proxies:                         # la calibración de proxies_crudos.csv (?dl_calibrar_proxies)
#>   transformacion:
#>     haqi: diferencia             # un índice de 0 a 100: en puntos; el SEV y el LDI, en cociente
#>
#> sensibilidad:
#>   peso: [0.1, 0.5, 1.0]
#>
#> subtipos: [9101, 9102, 9103]
#>
#> notas:
#>   - Datos sintéticos de ejemplo (dismodlite).
Las covariables y su efecto están en la tabla betas. Cada fila dice sobre qué actúa la covariable (efecto_sobre), en qué escala se estimó su β (transformacion) y su β con el intervalo del 95 % publicado:
fread(dl_ejemplo("betas.csv"), encoding = "UTF-8")[, .(causa, covariable, efecto_sobre, transformacion, beta,
                                                       inferior, superior)]
#>    causa                covariable      efecto_sobre transformacion   beta
#>    <int>                    <char>            <char>         <char>  <num>
#> 1:  9100 SEV_scalar_agestd_cvd_pvd       prevalencia            log  0.620
#> 2:  9100                    LDI_pc       prevalencia            log -0.210
#> 3:  9100                      haqi mortalidad_exceso         lineal -0.012
#>    inferior superior
#>       <num>    <num>
#> 1:    0.550    0.700
#> 2:   -0.300   -0.120
#> 3:   -0.018   -0.006
Los subtipos 9101, 9102 y 9103 no tienen filas propias: usan las de su causa padre, la 9100.
- el SEV (el valor resumen de la exposición a un riesgo; más alto, más riesgo) y el LDI (el ingreso por persona) actúan sobre la prevalencia, a través de la incidencia (mueven log i), en escala log;
- el HAQ (acceso y calidad de la atención) actúa sobre la mortalidad en exceso (mueve log f), en escala lineal.
Sus valores subnacionales, los proxies, son las filas subnacionales de la tabla covariables: el valor de cada covariable en cada ubicación, en la escala de la descarga del GHDx, con su error estándar. El promedio de las ubicaciones, ponderado por su población, debe ser el valor nacional de la covariable. Esos valores pueden llegar ya calibrados a covariables (la guía Preparar tus datos explica el requisito de cierre) o salir de una encuesta, como en el ejemplo.
De la encuesta a la covariable
Casi nunca hay una covariable de GBD por ubicación subnacional. Lo que suele haber es un indicador de una encuesta de hogares, o de otra fuente con ediciones, que se mueve con ella: la proporción de hogares con un servicio, el gasto por persona, un índice de acceso. Ese indicador no está en la escala de la covariable, su nivel cambia de una edición a otra por razones propias de la encuesta y cada edición trae ruido de muestreo. Lo que sí informa es la posición relativa de cada ubicación. La tabla proxies_crudos trae esos valores tal como se publican, ya agregados por ubicación y edición, con su error estándar. dl_proyecto() los calibra al leer el proyecto: de ellos salen las filas subnacionales de covariables del año que se estima.
El ejemplo trae una encuesta sintética con tres ediciones (2019, 2021 y 2023) y un indicador por covariable. Para el HAQ es un índice de 0 a 100 cuyo nivel no es el del GHDx. Huancavelica (09) y Lima (15) en cada edición:
proyecto <- dl_proyecto(dl_ejemplo(), causa = 9100)
crudos <- proyecto$tablas$proxies_crudos
crudos[covariable == "haqi" & ubicacion %in% c("09", "15"), .(ubicacion, anio, indicador, valor, error_estandar)]
#>    ubicacion  anio                                             indicador valor
#>       <char> <int>                                                <char> <num>
#> 1:        09  2019 indicador sintético de acceso a la atención (0 a 100) 32.33
#> 2:        15  2019 indicador sintético de acceso a la atención (0 a 100) 46.48
#> 3:        09  2021 indicador sintético de acceso a la atención (0 a 100) 31.66
#> 4:        15  2021 indicador sintético de acceso a la atención (0 a 100) 49.94
#> 5:        09  2023 indicador sintético de acceso a la atención (0 a 100) 34.05
#> 6:        15  2023 indicador sintético de acceso a la atención (0 a 100) 52.41
#>    error_estandar
#>             <num>
#> 1:              2
#> 2:              1
#> 3:              2
#> 4:              1
#> 5:              2
#> 6:              1
La calibración tiene tres pasos, por covariable, sexo y banda de edad.
1. El gradiente de cada edición. En la edición , cada ubicación se compara con el promedio de la edición, ponderado por su población (la del año de poblacion más cercano a ):
con su error (cociente, la aproximación delta de la escala log) o (diferencia). El promedio se toma sobre las ubicaciones que están en todas las ediciones, así que no se mueve si una edición no trae alguna. El gradiente ya no depende del nivel de la encuesta: solo de dónde está cada ubicación respecto de las demás.
2. El gradiente del año que se estima. El gradiente verdadero de cada ubicación, , cambia poco a poco: se modela como un paseo aleatorio, del que cada edición da una observación con error,
con los años entre ediciones. Un filtro de Kalman y un suavizador (RTS) dan, con todas las ediciones de la ubicación, el gradiente en el año que se estima, : su media y su varianza , haya o no una edición ese año. , la varianza por año del gradiente, se estima por máxima verosimilitud, una por covariable con todas sus ubicaciones, sexos y bandas.
3. El cierre. Con , el valor nacional de la covariable en el año que se estima, y , la población de cada ubicación en ese año:
con error o . Por construcción, : los proxies calibrados cierran exactamente en el valor nacional. El error no incluye la incertidumbre de la normalización ni la del valor nacional (que la estimación subnacional ya sortea por su cuenta).
El resultado está en proyecto$calibracion; su atributo calibracion resume cada covariable:
calibracion <- proyecto$calibracion
attr(calibracion, "calibracion")[, .(covariable, metodo, transformacion, q, ediciones)]
#>                   covariable          metodo transformacion            q
#>                       <char>          <char>         <char>        <num>
#> 1: SEV_scalar_agestd_cvd_pvd paseo_aleatorio       cociente 2.255044e-05
#> 2:                    LDI_pc paseo_aleatorio       cociente 3.734479e-04
#> 3:                      haqi paseo_aleatorio     diferencia 4.055032e-01
#>           ediciones
#>              <char>
#> 1: 2019, 2021, 2023
#> 2: 2019, 2021, 2023
#> 3: 2019, 2021, 2023
# el cierre del LDI, con la población de 2023
ldi <- calibracion[covariable == "LDI_pc"]
pob <- proyecto$tablas$poblacion[anio == 2023, .(w = sum(poblacion)), by = ubicacion]
ldi <- merge(ldi, pob, by = "ubicacion")
c(promedio = ldi[, sum(w * valor) / sum(w)],
  nacional = proyecto$tablas$covariables[covariable == "LDI_pc" & anio == 2023, valor])
#> promedio nacional
#>    11040    11040
Cómo leer q. es cuánto se mueve el gradiente en un año: en log (una proporción) con cociente, en las unidades del indicador con diferencia. Con q chico el gradiente casi no cambia y el resultado es la media de las ediciones, ponderada por : las ediciones se promedian y el ruido de muestreo se cancela. Con q grande cada edición manda y el resultado se acerca al de la edición del año (el método edicion). En el ejemplo, la posición de cada ubicación en el SEV se mueve alrededor de 0.5 % por año y en el LDI, alrededor de 1.9 %; la del HAQ, alrededor de 0.64 puntos por año. q se busca entre y , con la mediana de de la covariable: un intervalo relativo al error de las ediciones, para que el resultado no dependa de las unidades del indicador (con diferencia, el mismo índice en una escala 100 veces mayor da los mismos valores por 100 y q por ). Si q queda en el borde inferior de ese intervalo, el gradiente es prácticamente constante y la revisión lo dice; en el superior, cada edición manda y el paquete avisa. Con pocas ediciones (tres en el ejemplo) la verosimilitud de q es plana: q puede moverse órdenes de magnitud con una edición más o menos. Léelo como el grado de suavizado que eligen estos datos, no como una propiedad estable del indicador. Con una sola edición por serie, q no se estima y se usa esa edición.
El gráfico muestra el gradiente observado de cada edición (puntos, con su intervalo del 95 %) y el suavizado (líneas) del HAQ en seis departamentos. Las líneas casi planas dicen que la posición de cada departamento cambia poco entre ediciones; el suavizado promedia el ruido de muestreo, que es mayor en los departamentos chicos (intervalos anchos):
series <- attr(calibracion, "series")[covariable == "haqi"]
elegidas <- c("15", "04", "13", "21", "03", "09")
nombres_px <- proyecto$tablas$ubicaciones[match(elegidas, ubicacion), nombre]
colores <- c("#08519c", "#3182bd", "#6baed6", "#fd8d3c", "#e6550d", "#a63603")
plot(NA, xlim = c(2018.5, 2025.5), ylim = range(series[ubicacion %in% elegidas, g + c(-2, 2) * se_g]),
     xlab = "Edición", ylab = "Gradiente del HAQ (puntos frente al promedio)", xaxt = "n",
     main = "De la encuesta a la covariable: observado y suavizado", sub = "Datos sintéticos")
axis(1, at = c(2019, 2021, 2023))     # a la derecha queda lugar para la leyenda
abline(h = 0, lty = 2, col = "grey60")
for (k in seq_along(elegidas)) {
  s <- series[ubicacion == elegidas[k]][order(anio)]
  x <- s$anio + (k - 3.5) * 0.06
  segments(x, s$g - 1.96 * s$se_g, x, s$g + 1.96 * s$se_g, col = colores[k])
  points(x, s$g, pch = 19, col = colores[k])
  lines(s$anio, s$g_suavizado, col = colores[k], lwd = 2)
}
legend("right", nombres_px, col = colores, lwd = 2, pch = 19, bty = "n", cex = 0.8)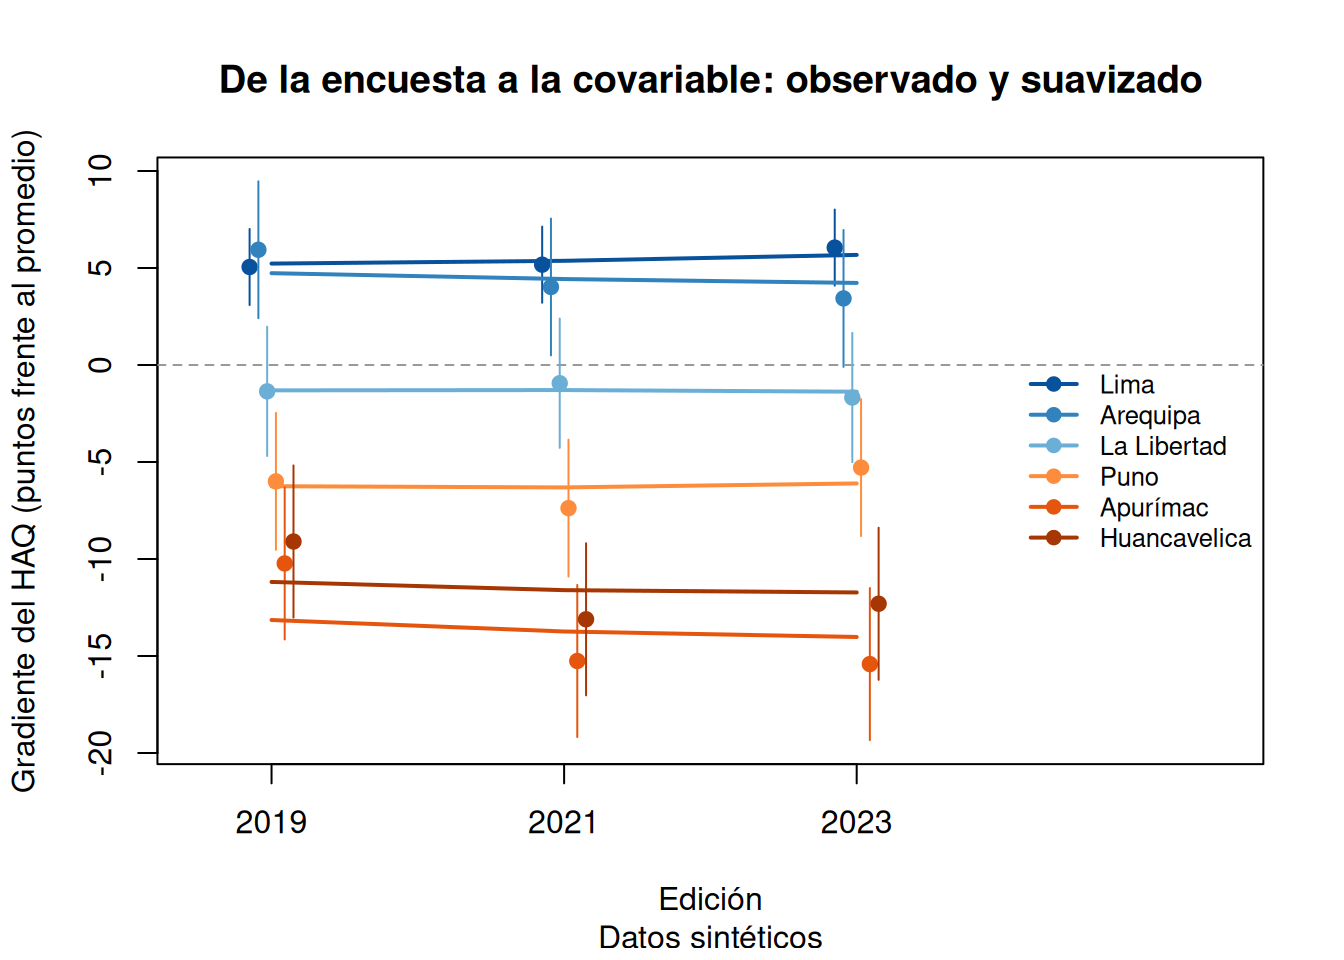
¿Cociente o diferencia? Cada covariable elige su transformación en proxies.transformacion (por defecto, cociente):
-
cocientecompara en proporción: una ubicación con el doble del promedio tiene el doble del valor nacional. Sirve para indicadores positivos que se comparan así (prevalencias, tasas, ingresos) y conviene a las covariables con transformaciónlogenbetas, que comparan razones. Exige valores mayores que 0. -
diferenciacompara en puntos: una ubicación 10 puntos sobre el promedio queda 10 puntos sobre el valor nacional. Sirve para índices en los que importa la distancia (como uno de 0 a 100) o indicadores que pueden valer 0, y conviene a las covariableslineal, que comparan diferencias.
El ejemplo declara el HAQ (lineal, de 0 a 100) en diferencia; el SEV y el LDI (log) quedan en cociente. Es el bloque proxies de la configuración de arriba. Otras dos claves completan la calibración: proxies.metodo (paseo_aleatorio, por defecto, o edicion, que toma la edición del año que se estima o la más cercana) y proxies.excluir, las ediciones que no entran, cada una con su motivo:
proxies:
  metodo: paseo_aleatorio
  transformacion: {haqi: diferencia}
  excluir: [{anio: 2021, motivo: cambio de modo de la encuesta}]
Una sola fuente por covariable. Las filas subnacionales de cada covariable vienen de covariables o de proxies_crudos, no de las dos; un proyecto puede calibrar unas covariables y traer otras ya calibradas. Para calibrar fuera de un proyecto (otro año, otra configuración), dl_calibrar_proxies() hace lo mismo con las tablas como argumentos; si covariables es la carpeta de descargas del GHDx, con varias ubicaciones, ubicacion_gbd dice cuál es el país (como en dl_tabla()).
Cómo queda registrada. print(proyecto) y dl_revisar_proyecto() (en su paso «proxies») dan, por covariable, el método, q y las ediciones. Cada corrida de dl_correr() guarda la tabla proxies_crudos tal como vino en inputs/contrato/ (y covariables sin las filas calibradas, así que repetir la corrida desde ahí vuelve a calibrar igual), las series observadas y suavizadas de cada ubicación en diagnostics/proxies_series.csv y, en el manifiesto, params.proxies: por covariable, el método, la transformación, q, si quedó en un borde, las ediciones usadas, las excluidas con su motivo y, si el valor nacional en que cierra es el de otra covariable, cuál (valor_nacional_de; más abajo).
Los proxies calibrados del ejemplo, el SEV por sexo y grupo de edad (de 40 a 44 años hasta 80 y más; aquí, el primer grupo) y el LDI y el HAQ para ambos sexos y todas las edades:
calibracion[ubicacion == "01" & (is.na(edad_inicio) | edad_inicio == 40), .(sexo, edad_inicio, covariable, valor,
                                                                            error_estandar)]
#>       sexo edad_inicio                covariable       valor error_estandar
#>     <char>       <num>                    <char>       <num>          <num>
#> 1: hombres          40 SEV_scalar_agestd_cvd_pvd    1.241727     0.02002737
#> 2: mujeres          40 SEV_scalar_agestd_cvd_pvd    1.136023     0.01830447
#> 3:   ambos          NA                    LDI_pc 5866.690895   209.27866225
#> 4:   ambos          NA                      haqi   40.915097     1.30869523
El ajuste nacional
proyecto$configuracion$origen$subnacional
#> [1] "covariables"
insumos <- dl_insumos(proyecto)
#> dl_insumos(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
opciones <- dl_opciones_mcmc(simulaciones = 200, cadenas = 2, iteraciones = 6000, calentamiento = 2000,
                             nucleos = 4)
ajuste <- dl_ajustar(insumos, opciones, semilla = 1)
ajuste
#> <dl_fit> insumos 0e52c7277b9a | semilla 1 | motor mh
#>   sexos: 1, 2 | simulaciones por sexo: 200 | edades 30-99
#>   R-hat máximo 1.059 | ESS mínimo 90 | aceptación 0.36-0.51
Las cadenas son cortas para que la guía corra en segundos (y nucleos = 4 las corre en paralelo, con el mismo resultado); una estimación para publicar usa las de producción, los valores por defecto de dl_opciones_mcmc() (ver Diagnóstico y sensibilidad). Las covariables no intervienen en el ajuste nacional: actúan solo en la estimación subnacional.
La cascada
dl_cascada() hace los cuatro pasos de arriba sobre cada simulación del ajuste (en una corrida completa, la llama dl_correr()):
cascada <- dl_cascada(ajuste, insumos, semilla = 1)
cascada
#> <dl_cascade> cascada subnacional por proxies | kappa 1.00 | 25 ubicaciones subnacionales | factor de renormalización [0.939, 1.036] | simulaciones subnacionales con la EMR truncada al techo: 0
#> <dl_fit> insumos 0e52c7277b9a | semilla 1 | motor mh
#>   sexos: 1, 2 | simulaciones por sexo: 200 | edades 30-99
#>   R-hat máximo 1.059 | ESS mínimo 90 | aceptación 0.36-0.51
En cada ubicación, sexo, edad a y simulación, el logaritmo de la incidencia es el nacional desplazado por las covariables que actúan sobre ella:
donde es la diferencia entre el valor transformado de la covariable c en la ubicación y el nacional (por su escala), κ = subnacional.kappa y se sortea de su intervalo, como el valor nacional y el subnacional de la covariable. Las covariables de mortalidad_exceso mueven igual log f, sin pasar de su techo (mortalidad_exceso.techo), y la remisión es la nacional. Con una covariable por grupo de edad, la diferencia se interpola entre los puntos medios de los grupos; fuera de ellos vale 0 (en el ejemplo, de 30 a 39 años para el SEV). La guía El modelo da cada paso con su ecuación.
Las diferencias quedan en cascada$dX, por simulación, ubicación, sexo, grupo de edad y covariable. Su media por ubicación muestra quién está por encima y por debajo del país:
diferencias <- cascada$dX[, .(dX = mean(dX)), by = .(location_id, covariate_name_short)]
dcast(diferencias, location_id ~ covariate_name_short, value.var = "dX")[1:6]
#> Key: <location_id>
#>    location_id      LDI_pc SEV_scalar_agestd_cvd_pvd       haqi
#>         <char>       <num>                     <num>      <num>
#> 1:          01 -0.63324284               -0.03745355  -9.903952
#> 2:          02 -0.09040857               -0.07428558  -2.780260
#> 3:          03 -0.97243712               -0.03737085 -14.149138
#> 4:          04  0.13071492                0.09032460   4.218152
#> 5:          05 -0.73132811                0.05604610  -2.217082
#> 6:          06 -0.84855905               -0.24631758  -6.431366
Un LDI más bajo que el nacional (dX negativo, β negativa) sube la incidencia; un HAQ más bajo (β negativa) sube la mortalidad en exceso.
El resultado por ubicación
dl_estimaciones() da la media y el intervalo de cada ubicación, sexo y edad. Como los datos son sintéticos, verdad.csv trae las curvas verdaderas de cada ubicación, con las que podemos comparar:
verdad <- fread(dl_ejemplo("verdad.csv"), colClasses = list(character = "location_id"))
verdad70 <- verdad[cause_id == 9100 & anio == 2023 & sex_id == 2 & edad == 70, .(location_id, verdad = p)]
nombres <- fread(dl_ejemplo("ubicaciones.csv"), colClasses = "character", encoding = "UTF-8")[
  , .(location_id = ubicacion, location_name = nombre)]

# prevalencia de las mujeres a los 70 años, por ubicación, de una cascada
a_los_70 <- function(cascada) {
  estimaciones <- dl_estimaciones(cascada)[sex_id == 2 & edad == 70]
  merge(merge(estimaciones, verdad70, by = "location_id"), nombres, by = "location_id", all.x = TRUE)
}
prevalencia_70 <- a_los_70(cascada)
nacional70 <- prevalencia_70[location_id == "123"]
prevalencia_70 <- prevalencia_70[location_id != "123"][order(media)]
op <- par(mar = c(5, 9, 3, 1))
filas <- seq_len(nrow(prevalencia_70))
plot(100 * prevalencia_70$media, filas, yaxt = "n", pch = 19, col = "#08519c",
     xlim = 100 * range(prevalencia_70$inferior, prevalencia_70$superior, prevalencia_70$verdad),
     xlab = "Prevalencia a los 70 años, mujeres (%)", ylab = "",
     main = "Estimación subnacional (modo covariables)", sub = "Datos sintéticos")
segments(100 * prevalencia_70$inferior, filas, 100 * prevalencia_70$superior, filas, col = "#08519c")
points(100 * prevalencia_70$verdad, filas, pch = 4, col = "#cb181d", lwd = 2)
abline(v = 100 * nacional70$media, lty = 2, col = "grey40")
axis(2, at = filas, labels = prevalencia_70$location_name, las = 1, cex.axis = 0.7)
legend("bottomright", c("estimación (media e IC 95 %)", "verdad", "nacional"), pch = c(19, 4, NA),
       lty = c(1, NA, 2), col = c("#08519c", "#cb181d", "grey40"), bty = "n", cex = 0.8)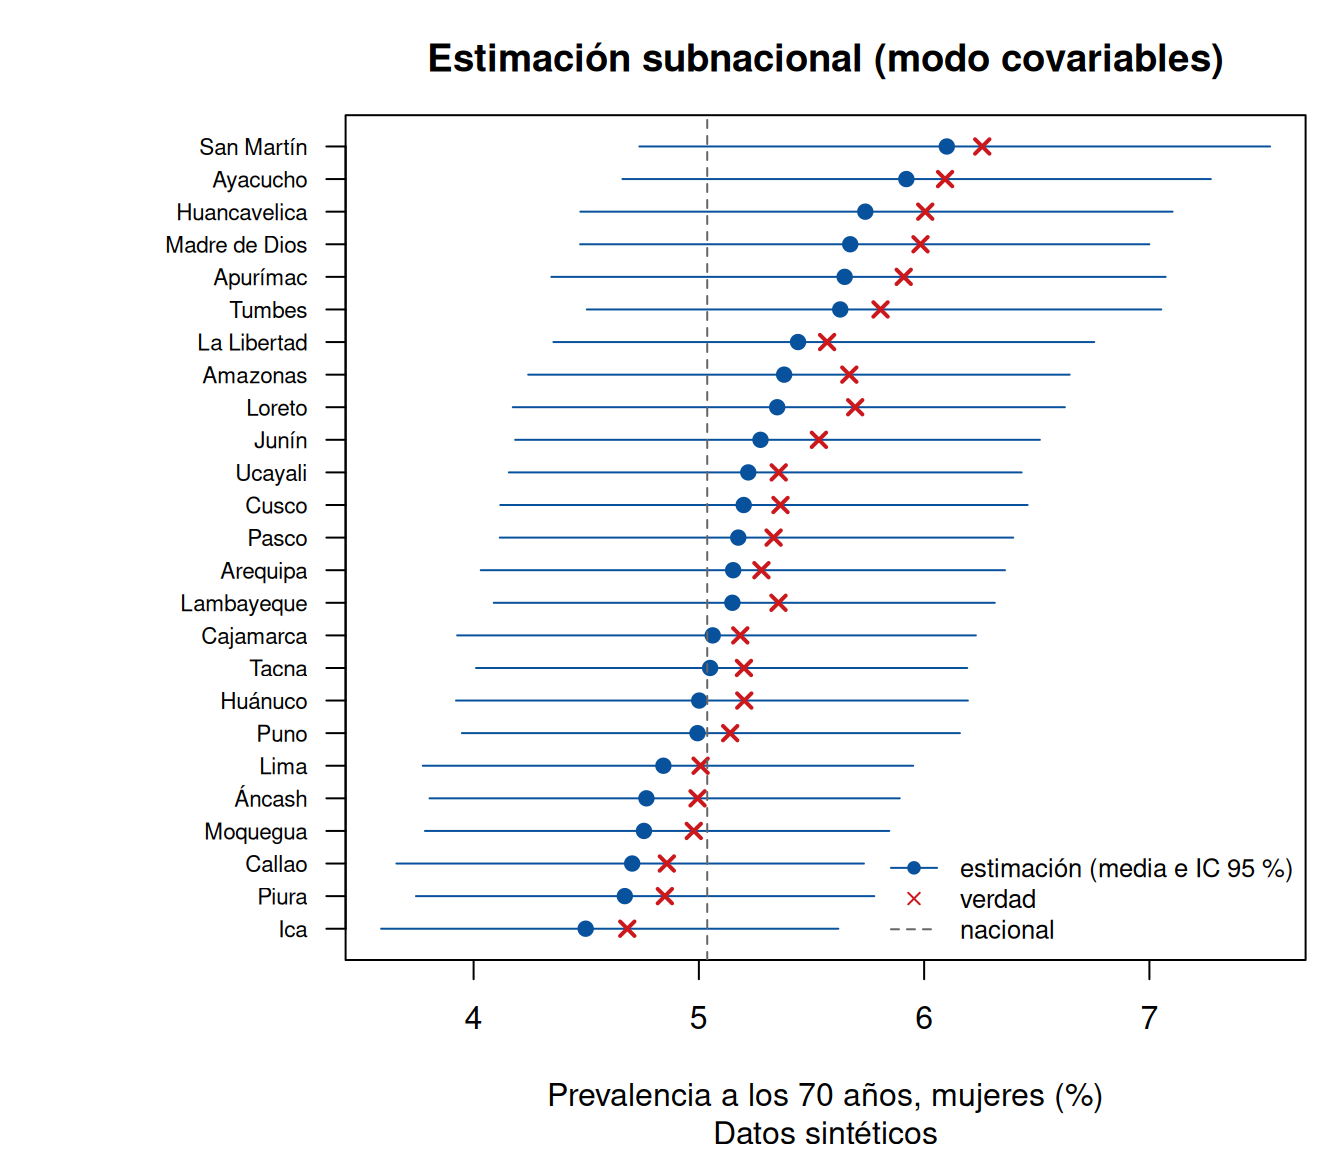
par(op)Las ubicaciones se ordenan como la verdad: las covariables recuperan el gradiente entre ubicaciones, con intervalos que reflejan la incertidumbre del ajuste nacional, de las covariables y de las β.
La renormalización
Desplazar las tasas mueve también el total: la suma de los casos de las ubicaciones ya no es exactamente la nacional. La renormalización lo corrige por sexo, grupo de edad de la población y simulación: multiplica la prevalencia (y la incidencia poblacional, i (1 − p)) de todas las ubicaciones por un mismo factor, los casos nacionales divididos por la suma de los casos de las ubicaciones, así que después suman exactamente los nacionales. Los factores quedan en cascada$renorm:
factores <- cascada$renorm[medida == "prevalence" & sex_id == 2]
grupos <- insumos$bandas_pobl[, .(age_group_id, edades = ifelse(age_end >= 125, paste0(age_start, "+"),
                                                                 paste0(age_start, "-", age_end - 1)))]
factores[, edades := factor(grupos$edades[match(age_group_id, grupos$age_group_id)], levels = grupos$edades)]
boxplot(factor ~ edades, data = factores, xlab = "Grupo de edad (años)", las = 2, cex.axis = 0.8,
        ylab = "Factor de renormalización", main = "Prevalencia, mujeres: un factor por simulación",
        sub = "Datos sintéticos", col = "#c6dbef")
abline(h = 1, lty = 2)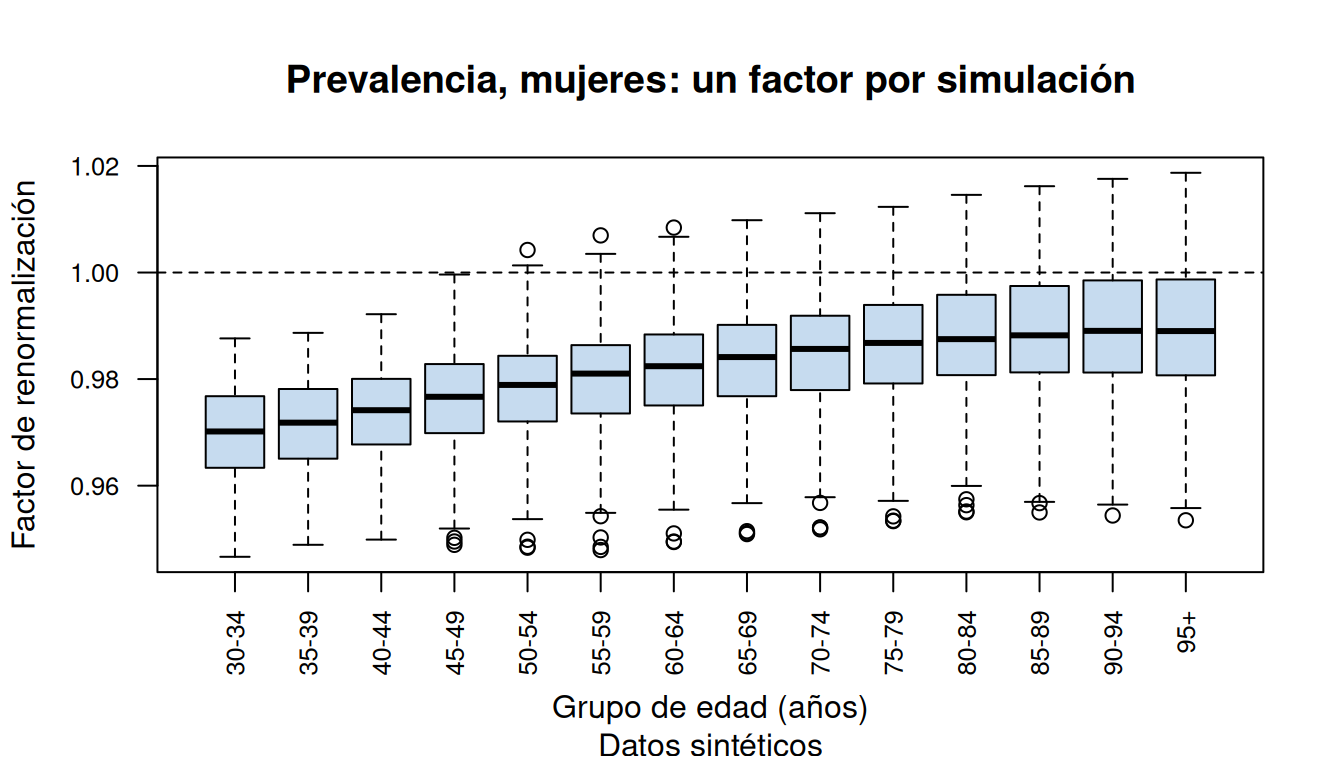
Un factor cerca de 1 dice que los desplazamientos casi se compensan entre ubicaciones, como deben hacerlo si los proxies cierran en el valor nacional. Suele quedar algo por debajo de 1: desplazamientos que se compensan en escala log suben un poco el promedio en la escala de las tasas. Se puede comprobar la suma en un grupo y una simulación:
# mujeres de 70 a 74 años (age_group_id 19), simulación 1
poblacion_70 <- insumos$poblacion[sex_id == 2 & age_group_id == 19, .(location_id, poblacion = val)]
prevalencia_simulacion1 <- cascada$draws_q[sex_id == 2 & draw == 1 & edad >= 70 & edad < 75,
                                           .(prevalencia = mean(p)), by = location_id]
prevalencia_simulacion1 <- merge(prevalencia_simulacion1, poblacion_70, by = "location_id")
c(nacional = prevalencia_simulacion1[location_id == "123", poblacion * prevalencia],
  suma_de_ubicaciones = prevalencia_simulacion1[location_id != "123", sum(poblacion * prevalencia)])
#>            nacional suma_de_ubicaciones
#>            21649.88            21649.88
La incidencia y la mortalidad en exceso por edad quedan como salen del modelo; se renormalizan la prevalencia y la incidencia poblacional, las medidas que se reportan.
κ, la fuerza del efecto subnacional
κ (subnacional.kappa, en (0, 1]) escala el desplazamiento: con 1, las diferencias entre ubicaciones son las que dan las β publicadas; con 0.5, la mitad. Conviene bajarlo cuando las β vienen de comparaciones entre países y podrían exagerar las diferencias dentro de uno, o cuando la validación (abajo) muestra un gradiente predicho más marcado que el observado.
κ no cambia el ajuste nacional, así que para ver su efecto basta con repetir la cascada; dl_cascada() lo acepta como argumento:
cascada05 <- dl_cascada(ajuste, insumos, kappa = 0.5, semilla = 1)En una corrida, κ va en la configuración (subnacional.kappa: 0.5), que queda registrada en el manifiesto; da la misma cascada.
Modo plano
En el modo plano cada ubicación recibe las tasas nacionales: no hay gradiente entre ubicaciones y los casos difieren solo por la población. Sirve cuando no hay covariables con valores subnacionales creíbles; la corrida lo declara como una limitación. Para probarlo, una copia del proyecto de ejemplo en una carpeta temporal (en un proyecto propio basta con editar su configuración):
plano <- dl_ejemplo(copiar_en = file.path(tempdir(), "plano"))Su configuración, config/9100.yaml, con modo: plano (las tablas betas y covariables quedan sin usar):
causa: 9100
anio: 2023
edad_inicio: 30

mortalidad_exceso:
  techo: 0.25

subnacional:
  modo: plano
  anio_validacion: 2019
insumos_plano <- dl_insumos(dl_proyecto(plano, causa = 9100))
#> dl_insumos(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
ajuste_plano <- dl_ajustar(insumos_plano, opciones, semilla = 1)
cascada_plano <- dl_cascada(ajuste_plano, insumos_plano, semilla = 1)
cascada_plano
#> <dl_cascade> cascada subnacional plana | kappa 1.00 | 25 ubicaciones subnacionales | factor de renormalización [1.000, 1.000] | simulaciones subnacionales con la EMR truncada al techo: 0
#> <dl_fit> insumos 47ee8bf6ccf5 | semilla 1 | motor mh
#>   sexos: 1, 2 | simulaciones por sexo: 200 | edades 30-99
#>   R-hat máximo 1.059 | ESS mínimo 90 | aceptación 0.36-0.51
El factor de renormalización es 1: la población subnacional ya suma la nacional.
Los tres resultados, lado a lado
La prevalencia de cada ubicación relativa a la nacional (mujeres, 70 años), con κ = 1, κ = 0.5 y el modo plano, frente a la verdad:
relativa <- function(cascada) {
  estimaciones <- a_los_70(cascada)
  estimaciones[, .(location_id, rel = media / media[location_id == "123"])][location_id != "123"]
}
comparacion <- Reduce(function(x, y) merge(x, y, by = "location_id"), list(
  relativa(cascada)[, .(location_id, k1 = rel)], relativa(cascada05)[, .(location_id, k05 = rel)],
  relativa(cascada_plano)[, .(location_id, plano = rel)],
  prevalencia_70[, .(location_id, location_name, verdad = verdad / verdad70[location_id == "123", verdad])]))
comparacion <- comparacion[order(verdad)]
op <- par(mar = c(5, 9, 3, 1))
filas <- seq_len(nrow(comparacion))
plot(comparacion$verdad, filas, xlim = range(comparacion[, .(k1, k05, plano, verdad)]), yaxt = "n", pch = 4, lwd = 2,
     col = "#cb181d", xlab = "Prevalencia relativa a la nacional (mujeres, 70 años)", ylab = "",
     main = "Efecto de κ y del modo plano", sub = "Datos sintéticos")
points(comparacion$k1, filas, pch = 19, col = "#08519c")
points(comparacion$k05, filas, pch = 1, col = "#08519c")
points(comparacion$plano, filas, pch = 15, col = "grey50", cex = 0.8)
abline(v = 1, lty = 2, col = "grey40")
axis(2, at = filas, labels = comparacion$location_name, las = 1, cex.axis = 0.7)
legend("bottomright", c("verdad", "κ = 1", "κ = 0.5", "plano"), pch = c(4, 19, 1, 15),
       col = c("#cb181d", "#08519c", "#08519c", "grey50"), bty = "n", cex = 0.8)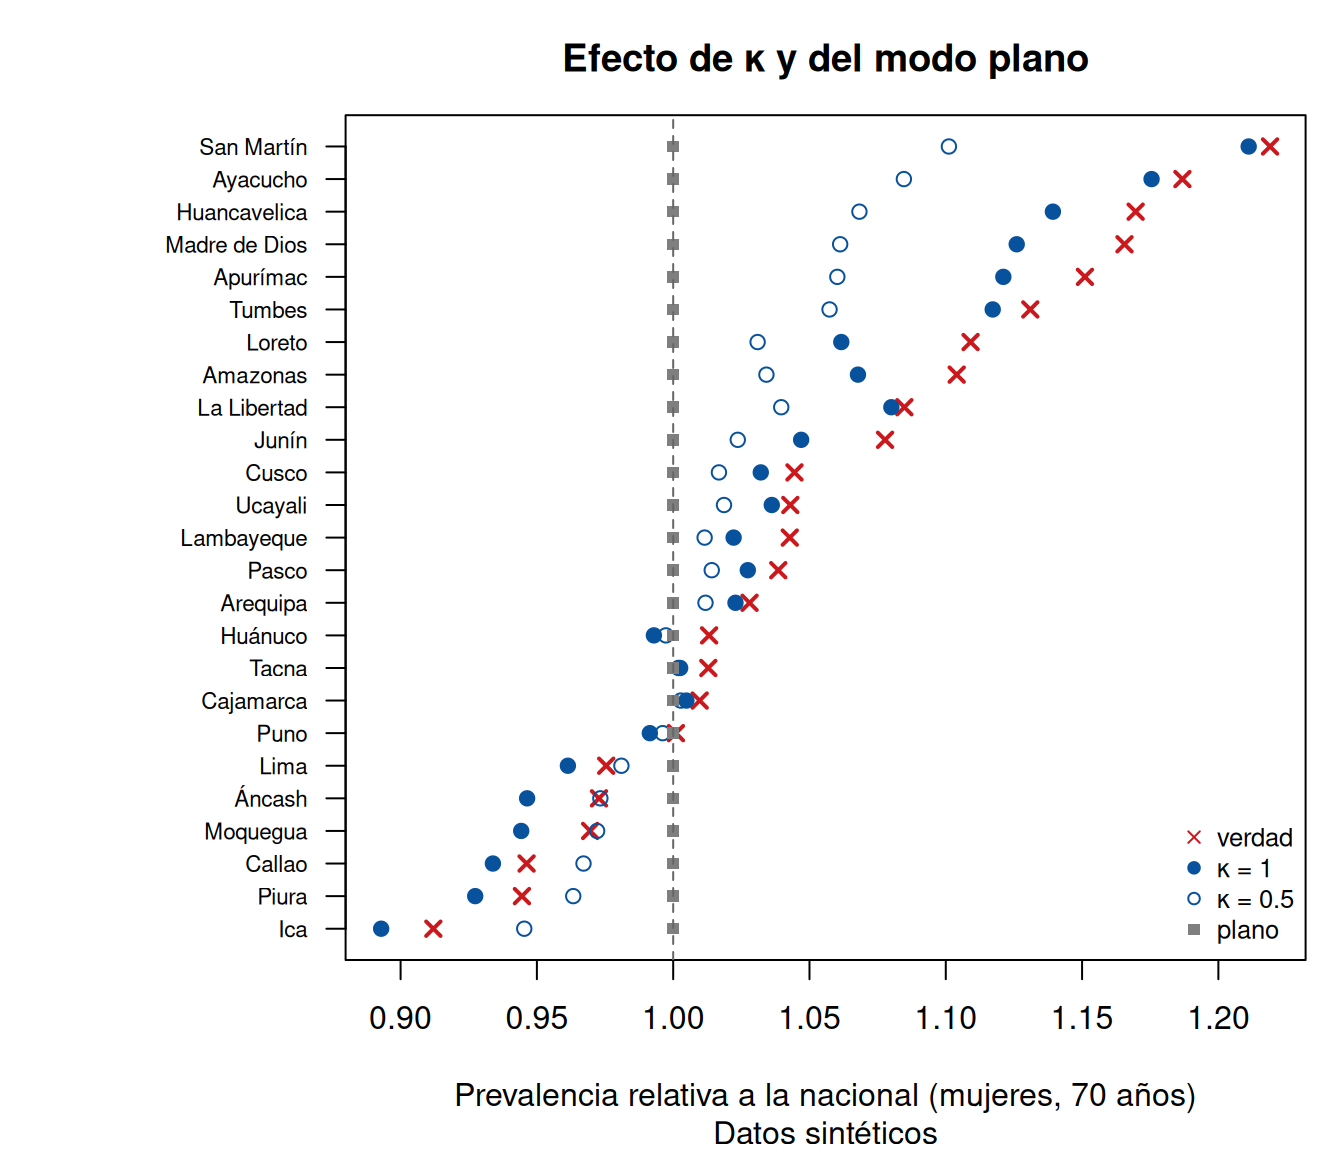
par(op)Con κ = 0.5 las ubicaciones se acercan a la nacional; en el modo plano todas valen lo mismo que el país. En este ejemplo sintético las covariables son informativas y κ = 1 reproduce mejor el gradiente verdadero; con datos reales no hay verdad, y la validación de la sección siguiente es la forma de decidirlo.
Modo razón
A veces el patrón entre ubicaciones no sale de covariables con una β publicada, sino de una razón ya calculada: la tasa de cada ubicación dividida por la nacional, estimada con una encuesta, con la población en riesgo o con los casos notificados. Con subnacional.modo: razon el modelo es el nacional y cada ubicación recibe la tasa nacional por su razón, simulación por simulación:
- La tabla
razonestrae, para cada ubicación y el año que se estima, la razón y el error estándar de su logaritmo (error_log). En cada simulación se sortea , con normal estándar. Con razón 0 la ubicación queda sin casos; conerror_log0 la razón no se sortea. - Por medida (prevalencia, incidencia y AVD), sexo y banda de edad, de modo que los casos de las ubicaciones suman los nacionales en cada simulación.
La razón es una por ubicación y año, la misma en todas las edades y sexos: la corrida lo declara como limitación. El nivel nacional no cambia, y la validación contra el ancla, los factores de renormalización, las etiquetas y la sensibilidad son los del ajuste nacional (la cascada plana). El modo no admite valores subnacionales de covariables (ni proxies_crudos): la razón ya es todo el patrón entre ubicaciones.
El modo se declara: nunca se deduce de las tablas, y en un proyecto solo con subnacional.modo (la clave avanzado: {cascada: {modo: }} no puede cambiarlo a razon ni desde razon: es un error de configuración). La tabla razones debe traer, en el año que se estima, todas las ubicaciones subnacionales de la población y ninguna otra (tampoco la nacional), con razon y error_log finitos y no negativos y alguna razón mayor que 0; dl_revisar_proyecto() lo comprueba antes de correr. El reparto se detiene con un error en dos casos: si en una celda las tasas repartidas no son finitas (por ejemplo, las ubicaciones con razón mayor que 0 no tienen población en esa celda), y el mensaje nombra el sexo y la banda; y si alguna prevalencia repartida pasa de 1, y el mensaje nombra las ubicaciones.
Para probarlo, otra copia del ejemplo, sin la encuesta de los proxies y con una tabla razones inventada: de 0.7 a 1.3 veces la tasa nacional, con un error del 5 % (en un proyecto propio es el archivo razones.csv, y el modo va en su configuración: subnacional: {modo: razon}):
carpeta_razon <- dl_ejemplo(copiar_en = file.path(tempdir(), "razon"))
unlink(file.path(carpeta_razon, "proxies_crudos.csv"))
ubicaciones <- read.csv(file.path(carpeta_razon, "ubicaciones.csv"), colClasses = "character")
subnacionales <- setdiff(ubicaciones$ubicacion, "123")
razones <- data.frame(ubicacion = subnacionales, anio = 2023,
                      razon = seq(0.7, 1.3, length.out = length(subnacionales)),
                      error_log = 0.05, fuente = "razones inventadas")
proyecto_razon <- dl_proyecto(carpeta_razon, razones = razones,
                              configuracion = list(causa = 9100, anio = 2023, edad_inicio = 30,
                                                   mortalidad_exceso = list(techo = 0.25),
                                                   subnacional = list(modo = "razon")))
insumos_razon <- dl_insumos(proyecto_razon)
#> dl_insumos(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
#> dl_insumos(): 160 fila(s) de la tabla datos de la causa 9100 quedan fuera: 160 de otro año (deben incluir 2023)
ajuste_razon <- dl_ajustar(insumos_razon, opciones, semilla = 1)
cascada_razon <- dl_cascada(ajuste_razon, insumos_razon, semilla = 1)   # la plana: las tasas nacionales
avd_razon <- dl_avd(cascada_razon, insumos_razon, semilla = 1)
reparto <- dl_repartir_razon(list(ajuste = cascada_razon, avd = avd_razon, insumos = insumos_razon))
reparto
#> <dl_reparto> reparto subnacional por razón | año 2023 | 25 ubicaciones | razones de 0.7 a 1.3 (0 en cero) | semilla 1
#>   simulaciones por medida: 200 | insumos 61eb4d9c2582
head(reparto$razones, 3)
#>    location_id razon error_log razon_media razon_lower razon_upper
#>         <char> <num>     <num>       <num>       <num>       <num>
#> 1:          01 0.700      0.05   0.6963622   0.6266363   0.7632814
#> 2:          02 0.725      0.05   0.7261477   0.6617257   0.8011474
#> 3:          03 0.750      0.05   0.7509735   0.6711640   0.8299607
#>                fuente
#>                <char>
#> 1: razones inventadas
#> 2: razones inventadas
#> 3: razones inventadasrazon_media, razon_lower y razon_upper resumen las razones sorteadas. Los casos de las ubicaciones suman los nacionales en cada simulación (la mayor diferencia relativa, en el último dígito):
pob <- insumos_razon$poblacion[, .(location_id, sex_id, age_group_id, N = val)]
x <- merge(reparto$draws$prevalence, pob, by = c("location_id", "sex_id", "age_group_id"))
casos <- x[, .(subnacional = sum(val[location_id != "123"] * N[location_id != "123"]),
               nacional = val[location_id == "123"] * N[location_id == "123"]),
           by = .(sex_id, age_group_id, draw)]
casos[, max(abs(subnacional / nacional - 1))]
#> [1] 4.440892e-16
El reparto es una pieza más del resumen, dl_resumir(list(ajuste = cascada_razon, avd = avd_razon, insumos = insumos_razon, reparto = reparto)), y dl_correr() hace todos los pasos en una llamada: escribe una sola corrida, ya repartida, con cascada.modo: razon, el bloque razon (la semilla del sorteo, cuántas ubicaciones, el rango de las razones, cuántas son cero y sus fuentes) y la limitación en su manifiesto, y la razón aplicada en diagnostics/razon.csv.
La semilla del sorteo de las razones es la de la corrida. Para fijar otra (por ejemplo, para que el sorteo no cambie al cambiar la semilla del ajuste), la clave razon_semilla, un entero no negativo, en el bloque avanzado de la configuración:
subnacional:
  modo: razon
avanzado:
  cascada:
    razon_semilla: 20250101
Validación con datos subnacionales reservados
Las filas subnacionales de la tabla datos nunca entran al ajuste. Las del año subnacional.anio_validacion (2019 en el ejemplo; por defecto, el año que se estima) se reservan para validar: con una cascada por covariables, la mortalidad por la causa observada en cada ubicación se compara con la predicha.
dl_validar_ancla() hace esa comparación cuando recibe la cascada. Por sexo, ajusta la recta de log(observada / nacional) sobre log(predicha / nacional) entre ubicaciones: una pendiente cerca de 1 dice que el gradiente predicho tiene la amplitud del observado; mayor que 1, que el predicho es demasiado plano; menor que 1, demasiado marcado. La correlación de rangos (Spearman) mide si el orden de las ubicaciones es el correcto. Las columnas _std repiten el cálculo con tasas estandarizadas por edad, un punto por ubicación.
columnas <- c("sex_id", "kappa", "pendiente", "pendiente_lower", "pendiente_upper", "spearman",
              "pendiente_std", "n_departamentos")
validacion <- dl_validar_ancla(ajuste, insumos, cascada = cascada)
validacion05 <- dl_validar_ancla(ajuste, insumos, cascada = cascada05)
rbind(attr(validacion, "amplitud")[, ..columnas], attr(validacion05, "amplitud")[, ..columnas])
#>    sex_id kappa pendiente pendiente_lower pendiente_upper  spearman
#>     <int> <num>     <num>           <num>           <num>     <num>
#> 1:      1   1.0  1.003791       0.8377543        1.169828 0.7878788
#> 2:      2   1.0  1.050155       0.9130361        1.187273 0.8060606
#> 3:      1   0.5  1.952045       1.6144446        2.289646 0.7939394
#> 4:      2   0.5  2.087514       1.8187305        2.356298 0.8181818
#>    pendiente_std n_departamentos
#>            <num>           <int>
#> 1:      1.014177              10
#> 2:      1.069398              10
#> 3:      2.015930              10
#> 4:      2.126748              10
n_departamentos es el número de ubicaciones subnacionales con datos reservados en la comparación (un nombre de la versión 0.2.2; ver los nombres anteriores). Con κ = 1 la pendiente queda cerca de 1; con κ = 0.5, cerca de 2: el gradiente predicho es más plano que el observado. La comparación es entre gradientes (cada ubicación relativa a la nacional), no entre niveles: por eso sirven datos de otro año, siempre que las diferencias entre ubicaciones cambien poco entre ese año y el que se estima. La validación de amplitud no se calcula en el modo plano ni en el modo razón (no hay un gradiente por covariables que comparar) ni sin datos subnacionales de mortalidad; la corrida dice por qué. El análisis de sensibilidad repite la cascada con cada valor de sensibilidad.kappa (ver Diagnóstico y sensibilidad).
Modo no
Con modo: no la estimación es solo nacional, aunque la población traiga ubicaciones subnacionales. Es el valor por defecto cuando la población trae solo la ubicación nacional. En la configuración:
subnacional:
  modo: "no"
dl_correr() omite entonces la cascada y lo dice en un mensaje. (Las comillas en "no" son opcionales: el paquete lee no como texto, pero así el archivo se lee igual en cualquier lector de YAML.)
El valor nacional de otra covariable
La diferencia compara el valor de cada ubicación con el valor nacional de la misma covariable. A veces los dos no existen con el mismo nombre: la β se publicó para una covariable por edad y los valores subnacionales que hay se comparan con su versión estandarizada por edad, que en el GHDx es otra covariable. La columna valor_nacional_de de betas lo declara en la fila de la β:
covariable,efecto_sobre,transformacion,beta,inferior,superior,valor_nacional_de
sev_por_edad,prevalencia,log,0.62,0.55,0.70,sev_estandarizado
Con ella:
- el valor nacional que se resta en , y en el que deben cerrar los proxies de
sev_por_edad, es el desev_estandarizadoen el año del ancla; -
covariablestrae la fila nacional desev_estandarizado(con su intervalo) y las filas subnacionales desev_por_edad; la fila nacional desev_por_edadno hace falta. La exención es para una covariable con valores subnacionales (encovariableso enproxies_crudos): sin ellos no hay proxy que anclar, y la β sigue pidiendo la fila nacional de su propia covariable; - si los valores subnacionales vienen de
proxies_crudos, la calibración cierra en el valor nacional desev_estandarizado(dl_proyecto()lo toma debetas; a mano, el argumentovalor_nacional_dededl_calibrar_proxies()), y la calibración lo declara: en el paso «proxies» de la revisión y enparams.proxiesdel manifiesto.
La corrida lo deja escrito en el manifiesto (cascada.sustituciones) y en sus limitaciones.
La escala de una covariable
Con una covariable lineal, la diferencia entre la ubicación y el país se multiplica por escala antes de la β; con log o logit, escala no interviene y la revisión la rechaza si no es 1. escala (1 por defecto) sirve cuando la β publicada se estimó con la covariable en otras unidades que las de la descarga. Por ejemplo, el índice de acceso y calidad de la atención viene del GHDx en 0-100; si su β se publicó por unidad del índice en 0-1 (aquí, −1.2), se escribe tal cual en betas, con escala 0.01:
covariable,efecto_sobre,transformacion,escala,beta,inferior,superior
haqi,mortalidad_exceso,lineal,0.01,-1.2,-1.8,-0.6
Es lo mismo que la β del ejemplo, −0.012 (de −0.018 a −0.006) por punto del índice en 0-100, con escala 1. La escala queda en los insumos (insumos$betas) y en el manifiesto de la corrida.
Olvidar la escala es un error frecuente justamente con este índice, y el paquete lo comprueba: una covariable llamada haqi, lineal, con escala 1 y una β de 0.1 o más en valor absoluto detiene dl_insumos(). Con la descarga en 0-100, una ubicación 20 puntos por encima del país tendría su tasa multiplicada por exp(20 × β), casi 0 con β = −1.2. Una copia del ejemplo con esa β y sin la escala:
dl_insumos(dl_proyecto(sin_escala, causa = 9100))
#> Error:
#> ! dl_insumos(): la beta de haqi (-1.2 por unidad) con escala 1 (0-100) no es creíble: exp(beta x 20 puntos) es casi 0. En su fila de la tabla betas, escribe escala 0.01 (beta estimada en 0-1) o, si la beta es de verdad por punto de 0-100, escala_confirmada true
Si la β de verdad es por punto del índice en 0-100, se confirma en su fila de betas, con escala_confirmada en true, y la decisión conviene explicarla en notas.
Siguientes pasos
-
Preparar tus datos: los valores subnacionales de las covariables, las tablas
covariablesyproxies_crudosy el requisito de cierre en el valor nacional. -
?dl_calibrar_proxies: la calibración deproxies_crudosen detalle, con sus aproximaciones. - Datos locales: qué datos entran al ajuste nacional y cuáles validan.
- Subtipos y suma: la estimación subnacional de una causa que es la suma de otras.
- Carga: los años vividos con discapacidad: los AVD, también por ubicación.
- El modelo: las ecuaciones completas.
- Todas las claves, con sus valores por defecto, en
?dl_configuracion; las tablas, en?dl_tablas.