
library(dismodlite)
library(data.table)
#>
#> Attaching package: 'data.table'
#> The following object is masked from 'package:base':
#>
#> %notin%Qué vas a aprender
- Cómo calcula dismodlite los años vividos con discapacidad (AVD) a partir de la prevalencia.
- Qué va en la tabla de severidad (
severidad.csv): los estados de salud, sus proporciones y sus pesos de discapacidad. - Cómo se propaga la incertidumbre de la severidad.
- Qué es el factor de comorbilidad, cómo se calibra con el AVD del ancla y qué consecuencia tiene.
- Cómo obtener los AVD por ubicación, en tasas y en conteos.
El ejemplo es el proyecto sintético del paquete (la arteriopatía crónica sintética, causa 9100, en el Perú y sus departamentos). Todo vale igual para cualquier país y causa.
La ecuación
Cada año que una persona vive con la enfermedad pierde algo de salud, según el estado de salud en que está: nada si es asintomática, algo en un estado leve, más en uno moderado… Si una fracción πe de los casos está en el estado e y ese estado tiene un peso de discapacidad DWe (entre 0, salud plena, y 1), el peso medio por caso es Σe πe DWe. Los AVD por persona de un grupo de edad b son
con la prevalencia del grupo y el factor de comorbilidad (abajo). Se calcula en cada simulación k, así que la incertidumbre de la prevalencia y la de la severidad llegan a los AVD. La unidad es años vividos con discapacidad por persona y año: por 100 000 da la tasa y por la población, el número de AVD.
La tabla de severidad
La tabla severidad (severidad.csv) trae, para cada causa, sus estados de salud con la proporción de los casos que está en cada uno y su peso de discapacidad, los dos con su intervalo del 95 %:
severidad <- fread(dl_ejemplo("severidad.csv"), encoding = "UTF-8")
severidad[causa == 9100]
#>    causa                            estado id_estado proporcion  inferior
#>    <int>                            <char>     <int>      <num>     <num>
#> 1:  9100                      Asintomático       799  0.5277128 0.4485559
#> 2:  9100     Arteriopatía sintomática leve      9801  0.3222872 0.2739441
#> 3:  9100 Arteriopatía sintomática moderada      9802  0.1500000 0.1275000
#>     superior peso_discapacidad peso_inferior peso_superior
#>        <num>             <num>         <num>         <num>
#> 1: 0.6068697              0.00         0.000         0.000
#> 2: 0.3706303              0.02         0.012         0.031
#> 3: 0.1725000 0.07 0.046 0.102- Las proporciones de una causa suman 1. Suelen salir de la distribución de la severidad que publica GBD para la causa, o de un estudio local.
- Los pesos de discapacidad suelen ser los que publica GBD para cada estado de salud (un estado asintomático pesa 0). Si
estadoes un estado de salud de GBD (por su nombre o su id), los pesos pueden quedar vacíos: salen del catálogo de GBD 2023 que trae el paquete. Un estado propio, como los del ejemplo, necesita sus tres pesos. En cualquier estado van los tres pesos (peso_discapacidad,peso_inferiorypeso_superior) o ninguno. -
id_estadoes opcional: el identificador del estado (el de GBD, si es uno de GBD).
Sin severidad no hay AVD: dl_correr() lo comprueba antes de ajustar y dl_revisar_proyecto() lo marca como error.
El peso medio por caso de la causa 9100, con los valores centrales:
peso_medio <- severidad[causa == 9100, sum(proporcion * peso_discapacidad)]
peso_medio
#> [1] 0.01694574
Es decir, cada año con la enfermedad cuenta, en promedio, como 1.7 % de un año perdido por discapacidad.
El ajuste y los AVD
proyecto <- dl_proyecto(dl_ejemplo(), causa = 9100)
insumos <- dl_insumos(proyecto)
#> dl_insumos(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
opciones <- dl_opciones_mcmc(simulaciones = 200, cadenas = 2, iteraciones = 6000, calentamiento = 2000,
                             nucleos = 4)
ajuste <- dl_ajustar(insumos, opciones, semilla = 1)
comorbilidad <- dl_factor_comorbilidad(insumos)
avd <- dl_avd(ajuste, insumos, comorbilidad = comorbilidad, semilla = 1)
avd
#> <dl_yld> AVD por simulación | insumos 0e52c7277b9a | semilla 1 | factor de comorbilidad aplicado
#>   ubicaciones: 1 | bandas de edad y sexo: 24 | simulaciones: 200 | desplazamiento medio de las proporciones por la renormalización: 0.0012
Las cadenas son cortas para que la guía corra en segundos (y nucleos = 4 las corre en paralelo, con el mismo resultado); para publicar se usan las de producción. En una corrida, dl_correr() hace estos pasos (el factor de comorbilidad solo si el ancla trae AVD).
dl_estimaciones() resume los AVD por grupo de edad del ancla, por persona:
estimaciones <- dl_estimaciones(avd)[location_id == "123"]
estimaciones[, .(sex_id, age_group_id, por_100mil = round(1e5 * media, 1), inferior = round(1e5 * inferior, 1),
                 superior = round(1e5 * superior, 1))]
#>     sex_id age_group_id por_100mil inferior superior
#>      <int>        <int>      <num>    <num>    <num>
#>  1:      1           13       19.4     12.3     27.8
#>  2:      1           14       28.9     19.1     41.1
#>  3:      1           15       39.3     25.4     55.9
#>  4:      1           16       50.7     32.0     74.5
#>  5:      1           17       62.6     38.2     93.5
#>  6:      1           18       78.3     50.2    115.6
#>  7:      1           19       94.0     62.3    136.2
#>  8:      1           20      112.1     74.5    160.5
#>  9:      1           30      130.9     89.6    183.9
#> 10:      1           31      150.8    104.5    208.0
#> 11:      1           32      171.8    121.1    241.9
#> 12:      1          235      192.6    128.0    300.0
#> 13:      2           13       15.7      9.7     23.4
#> 14:      2           14       23.2     15.6     34.0
#> 15:      2           15       31.6     21.1     46.0
#> 16:      2           16       41.0     27.5     58.4
#> 17:      2           17       51.2     35.0     73.4
#> 18:      2           18       63.8     41.8     94.7
#> 19:      2           19       77.5     48.9    115.0
#> 20:      2           20       95.3     60.8    136.9
#> 21:      2           30      112.0     75.8    158.0
#> 22:      2           31      128.2     89.5    174.7
#> 23:      2           32      143.8     98.6    191.1
#> 24:      2          235      156.6    102.3    213.8
#>     sex_id age_group_id por_100mil inferior superior
#>      <int>        <int>      <num>    <num>    <num>
La incertidumbre de la severidad
En cada simulación, cada proporción y cada peso se sortean de una distribución Beta con su valor central como media y la varianza que implica su intervalo del 95 %, ((superior − inferior) / 3.92)². Las proporciones sorteadas se renormalizan para que sumen 1 en cada simulación. Un elemento sin incertidumbre (un intervalo de ancho 0, como el peso 0 del estado asintomático) entra como constante; uno cuyo intervalo es demasiado ancho para una Beta con esa media, también, con un aviso.
Sin el factor de comorbilidad, el cociente entre los AVD y la prevalencia de cada simulación es justamente su peso medio por caso, Σe πk,e DWk,e:
avd_sin_factor <- dl_avd(ajuste, insumos, comorbilidad = NULL, semilla = 1)
peso_k <- avd_sin_factor$draws_yld[location_id == "123" & sex_id == 2 & age_group_id == 19][order(draw)]$val /
  avd_sin_factor$draws_prev_banda[location_id == "123" & sex_id == 2 & age_group_id == 19][order(draw)]$val
summary(peso_k)
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
#> 0.01022 0.01484 0.01698 0.01687 0.01880 0.02489
hist(peso_k, breaks = 25, col = "#c6dbef", border = "white", main = "Peso medio por caso en cada simulación",
     xlab = expression(sum(pi[e] ~ DW[e], e)), ylab = "Simulaciones", sub = "Datos sintéticos")
abline(v = peso_medio, lwd = 2, col = "#cb181d")
legend("topright", "con los valores centrales", lwd = 2, col = "#cb181d", bty = "n", cex = 0.85)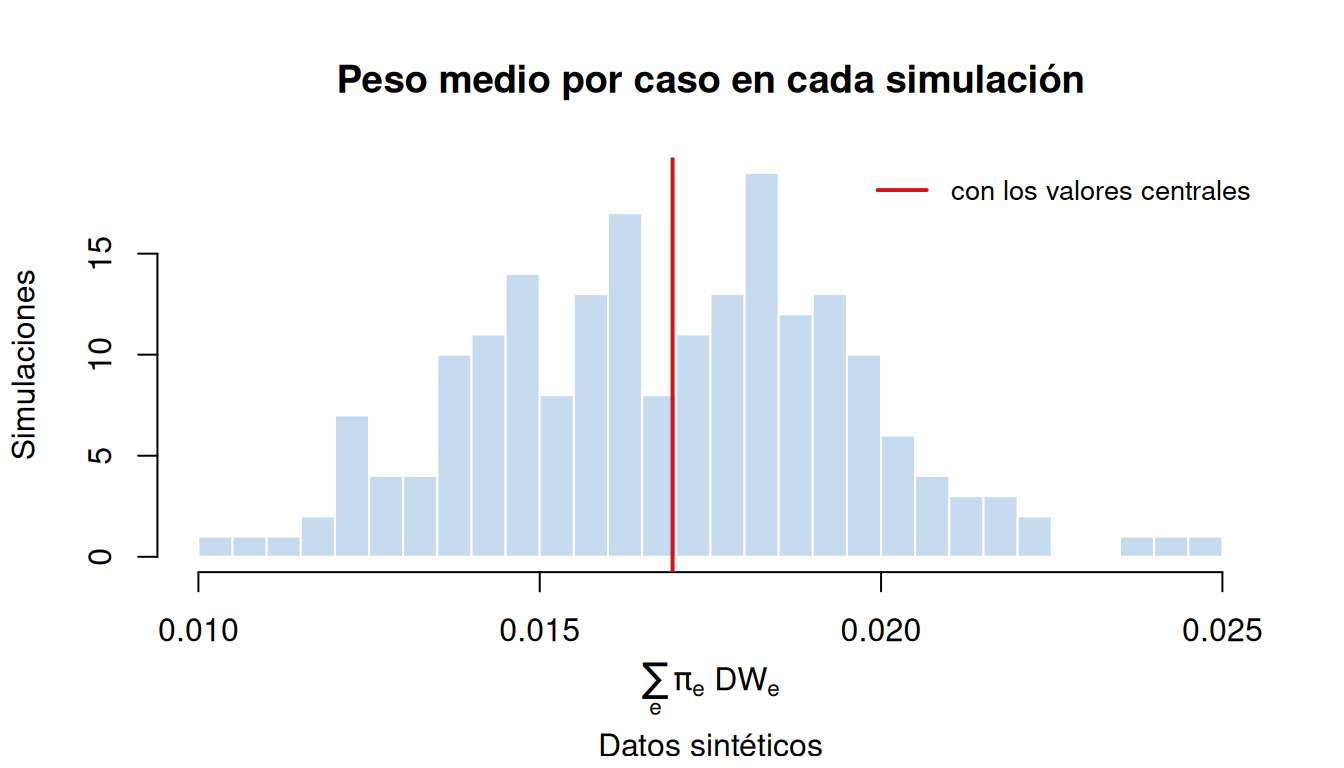
La renormalización mueve un poco la media de cada proporción; el desplazamiento queda en el resultado (y en diagnostics/desplazamiento_splits.csv de la corrida):
avd$desplazamiento_splits
#>    health_state_id prop_original prop_medio_renorm desplazamiento
#>              <int>         <num>             <num>          <num>
#> 1:             799     0.5277128         0.5264066  -0.0013061632
#> 2:            9801     0.3222872         0.3241106   0.0018233661
#> 3:            9802     0.1500000         0.1494828  -0.0005172029
El factor de comorbilidad
Una persona con varias enfermedades no suma sus pesos de discapacidad: su pérdida de salud es menor que la suma. GBD corrige los AVD por esa comorbilidad, y la corrección crece con la edad, porque las enfermedades se acumulan. El paquete no tiene las otras enfermedades de la población, así que calibra el factor con el AVD del ancla, grupo a grupo: es el AVD de referencia dividido por el que daría la tabla de severidad con la prevalencia del ancla, (la fórmula está en El modelo). Necesita las filas de AVD de la causa en el ancla (medida avd; en una descarga de GBD Results, measure_id 3, como tasa).
comorbilidad[, .(sex_id, age_group_id, factor = round(factor, 3))]
#>     sex_id age_group_id factor
#>      <int>        <int>  <num>
#>  1:      1           13  0.950
#>  2:      1           14  0.932
#>  3:      1           15  0.908
#>  4:      1           16  0.888
#>  5:      1           17  0.862
#>  6:      1           18  0.859
#>  7:      1           19  0.827
#>  8:      1           20  0.808
#>  9:      1           30  0.792
#> 10:      1           31  0.775
#> 11:      1           32  0.755
#> 12:      1          235  0.732
#> 13:      2           13  0.951
#> 14:      2           14  0.930
#> 15:      2           15  0.911
#> 16:      2           16  0.891
#> 17:      2           17  0.868
#> 18:      2           18  0.856
#> 19:      2           19  0.833
#> 20:      2           20  0.827
#> 21:      2           30  0.794
#> 22:      2           31  0.768
#> 23:      2           32  0.752
#> 24:      2          235  0.735
#>     sex_id age_group_id factor
#>      <int>        <int>  <num>
grupos <- insumos$prior_gbd[measure_id == 5 & sex_id == 1][order(age_start)]
edades <- sub(" years", "", grupos$age_group_name)
plot(seq_along(edades), comorbilidad[sex_id == 1][match(grupos$age_group_id, age_group_id)]$factor, type = "b",
     pch = 19, col = "#08519c", ylim = c(0.7, 1), xaxt = "n", xlab = "Grupo de edad", ylab = "Factor",
     main = "Factor de comorbilidad calibrado al ancla", sub = "Datos sintéticos")
lines(seq_along(edades), comorbilidad[sex_id == 2][match(grupos$age_group_id, age_group_id)]$factor, type = "b",
      pch = 17, col = "#e6550d")
axis(1, at = seq_along(edades), labels = edades, cex.axis = 0.8)
legend("bottomleft", c("hombres", "mujeres"), pch = c(19, 17), col = c("#08519c", "#e6550d"), lty = 1, bty = "n")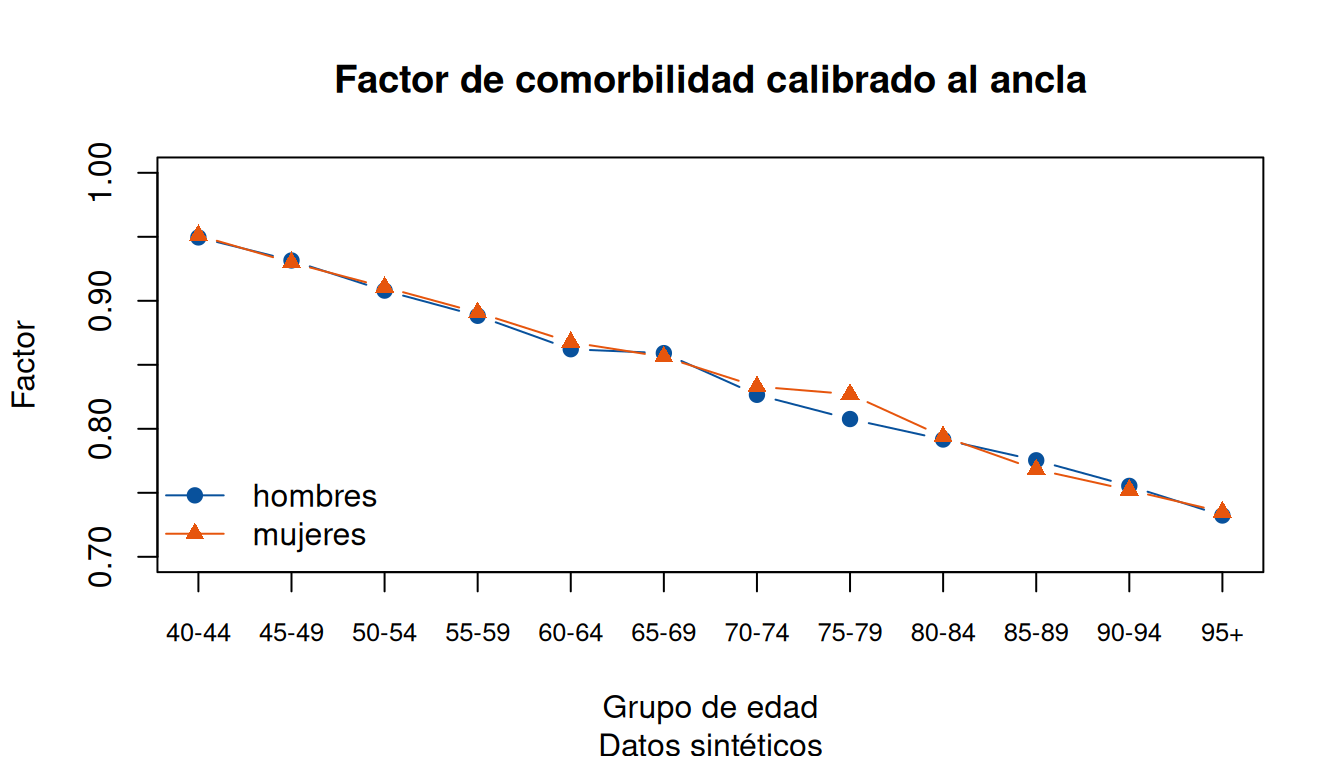
El factor es menor que 1 y baja con la edad, como la corrección por comorbilidad. Pero no es solo eso: como la tabla de severidad es la misma en todas las edades, el cociente absorbe también el patrón por edad de la severidad (y cualquier diferencia entre esta tabla y la que usó GBD). Por eso es una calibración por edad, no un factor de comorbilidad puro: no se trunca y puede superar 1.
Una consecuencia: el valor central sigue al AVD del ancla
Si se reemplaza el factor en la ecuación de arriba, la tabla de severidad se cancela en el valor central: los AVD de cada simulación son los del ancla por caso prevalente, llevados a la prevalencia ajustada y multiplicados por el cociente entre el peso medio por caso de la simulación y el de los valores centrales. Ese cociente vale cerca de 1 en promedio, pero varía entre simulaciones: con el factor, la tabla de severidad pesa en la incertidumbre, no en el valor central. Sin AVD en el ancla no hay factor, y entonces la tabla de severidad fija también el valor central (sin la corrección por comorbilidad, los AVD quedan sobreestimados, y el manifiesto lo declara).
La comparación con el AVD del ancla, grupo a grupo, con el factor y sin él:
# el AVD del ancla por banda de edad, por persona-año (las bandas del ancla, tal como vienen, son bandas de la
# población: su age_group_id está en insumos$bandas_pobl)
ancla <- proyecto$tablas$ancla[medida == "avd" & causa == 9100 & anio == 2023 & sexo == "mujeres"]
ancla <- merge(ancla, insumos$bandas_pobl, by.x = c("edad_inicio", "edad_fin"), by.y = c("age_start", "age_end"))[
  , .(age_group_id, ancla = valor)]
comparacion <- merge(dl_estimaciones(avd)[location_id == "123" & sex_id == 2], ancla, by = "age_group_id")
sin_factor <- dl_estimaciones(avd_sin_factor)[location_id == "123" & sex_id == 2]
comparacion <- merge(comparacion, sin_factor[, .(age_group_id, sin_factor = media)], by = "age_group_id")
posiciones <- seq_len(nrow(comparacion))
plot(posiciones, 1e5 * comparacion$media, ylim = c(0, max(1e5 * c(comparacion$superior, comparacion$sin_factor))),
     pch = 19, col = "#08519c", xaxt = "n", xlab = "Grupo de edad", ylab = "AVD por 100 000",
     main = "Mujeres: AVD del modelo y del ancla", sub = "Datos sintéticos")
segments(posiciones, 1e5 * comparacion$inferior, posiciones, 1e5 * comparacion$superior, col = "#08519c", lwd = 2)
points(posiciones, 1e5 * comparacion$ancla, pch = 4, col = "#cb181d", lwd = 2)
points(posiciones, 1e5 * comparacion$sin_factor, pch = 1, col = "grey40")
axis(1, at = posiciones, labels = edades, cex.axis = 0.8)
legend("topleft", c("modelo, con el factor (media e IC 95 %)", "AVD del ancla", "modelo, sin el factor"),
       pch = c(19, 4, 1), col = c("#08519c", "#cb181d", "grey40"), lty = c(1, NA, NA), lwd = c(2, 2, 1),
       bty = "n", cex = 0.85)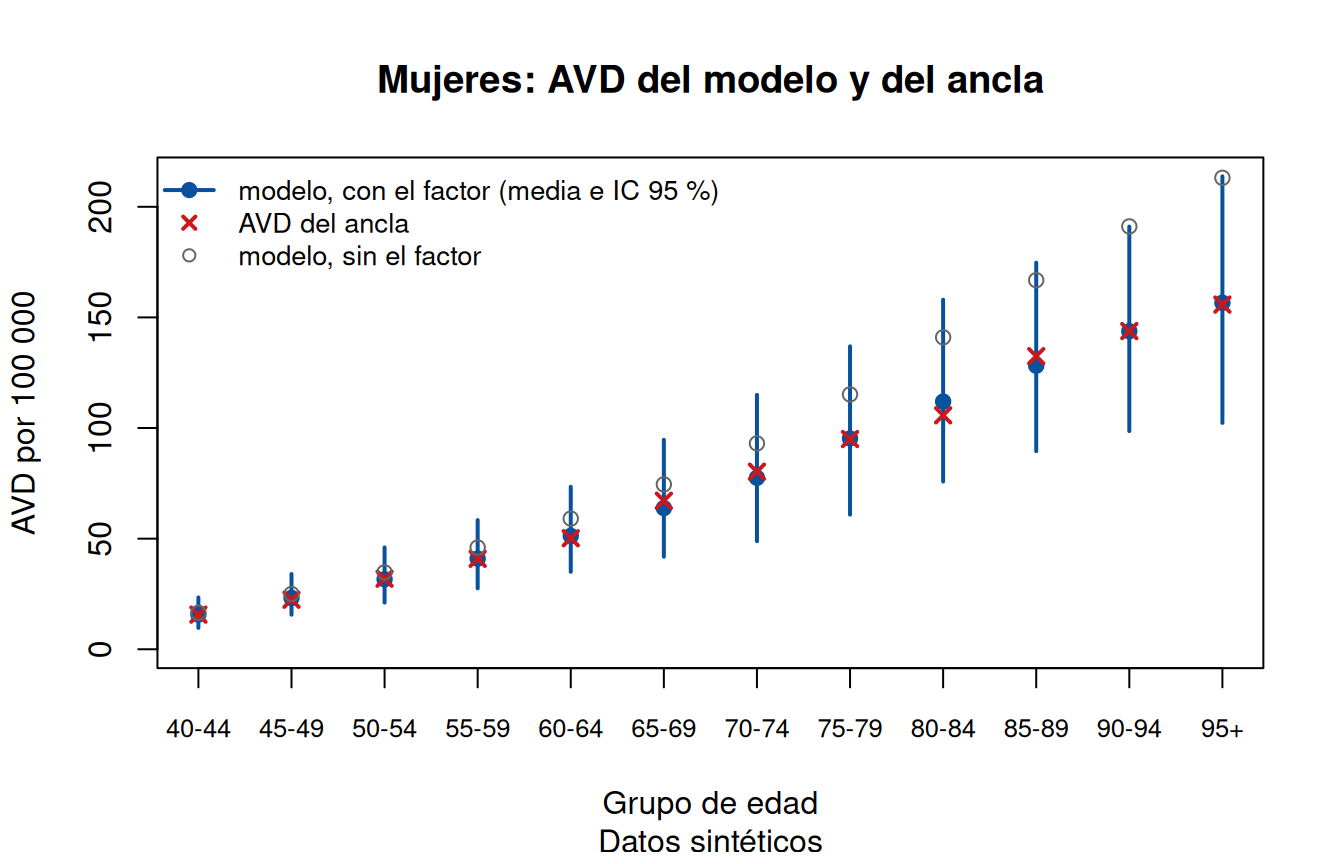
Con el factor, el modelo reproduce el AVD del ancla (la prevalencia ajustada sigue a la del ancla); sin él, los AVD quedan por encima, y más a mayor edad.
Los AVD por ubicación
Con una cascada, dl_avd() calcula los AVD de cada ubicación con su prevalencia; el peso medio por caso y el factor son los nacionales. La suma de los AVD de las ubicaciones, en número, es la nacional, porque la cascada renormaliza la prevalencia (ver la guía Estimación subnacional).
cascada <- dl_cascada(ajuste, insumos, semilla = 1)
avd_sub <- dl_avd(cascada, insumos, comorbilidad = comorbilidad, semilla = 1)
# población por ubicación, sexo y grupo de edad (los del ancla son bandas de la población)
poblacion <- insumos$poblacion[, .(location_id, sex_id, age_group_id, poblacion = val)]
numero <- merge(avd_sub$draws_yld, poblacion, by = c("location_id", "sex_id", "age_group_id"))[
  , .(avd = sum(val * poblacion)), by = .(location_id, draw)]
suma <- numero[location_id != "123", .(avd = sum(avd)), by = draw]
c(nacional = numero[location_id == "123", mean(avd)], suma_de_ubicaciones = suma[, mean(avd)])
#>            nacional suma_de_ubicaciones
#>            5600.407            5600.407
El número de AVD de cada ubicación (40 años y más, las edades del ancla; ambos sexos), con su intervalo, sale de las mismas simulaciones; las seis con más AVD:
nombres <- fread(dl_ejemplo("ubicaciones.csv"), colClasses = "character", encoding = "UTF-8")[
  , .(location_id = ubicacion, location_name = nombre)]
resumen <- numero[, .(media = mean(avd), inferior = quantile(avd, 0.025), superior = quantile(avd, 0.975)),
                  by = location_id]
resumen <- merge(resumen, nombres, by = "location_id", all.x = TRUE)
resumen[location_id != "123"][order(-media)][1:6, .(location_name, media = round(media),
                                                   inferior = round(inferior), superior = round(superior))]
#>    location_name media inferior superior
#>           <char> <num>    <num>    <num>
#> 1:          Lima  1850     1287     2586
#> 2:   La Libertad   378      266      521
#> 3:         Piura   320      224      439
#> 4:      Arequipa   264      186      367
#> 5:     Cajamarca   249      171      340
#> 6:         Junín   240      168      329
El intervalo se calcula sobre la suma de cada simulación, nunca sumando los límites de los grupos de edad. dl_correr() guarda las tasas de cada celda en cause/yld/ de la corrida (por 100 000) y las simulaciones en draws/.
Resumen
| Pieza | Dónde | Qué hace |
|---|---|---|
tabla severidad
|
proyecto | Estados de salud de cada causa: proporción y peso de discapacidad, con intervalos. |
| AVD en el ancla | proyecto |
medida avd (measure_id 3 en GBD Results, como tasa): calibra el factor de comorbilidad. |
dl_factor_comorbilidad() |
función | El factor por sexo y grupo de edad. |
dl_avd() |
función | Los AVD por simulación, ubicación, sexo y grupo de edad. |
dl_estimaciones(avd) |
función | Media e intervalo por celda, por persona. |
Siguientes pasos
-
Subtipos y suma: los AVD de una causa que es la suma de sus subtipos, y la severidad derivada de una partición (
severidad.particion). - Estimación subnacional: la prevalencia por ubicación de la que salen los AVD.
- El modelo: la notación y el resto de las ecuaciones.