
library(dismodlite)
nudos <- c(30, 40, 50, 60, 70, 80, 95)
log_i <- log(c(0.5, 0.8, 1.5, 2.5, 4, 6, 7) / 1000)        # incidencia por persona-año
log_f <- log(c(10, 12, 15, 20, 30, 50, 90) / 1000)         # mortalidad en exceso por persona-año
solucion <- dl_edo(log_i, log_f, nudos, edad_inicio = 30)
str(solucion)
#> List of 4
#>  $ edades: int [1:70] 30 31 32 33 34 35 36 37 38 39 ...
#>  $ p     : num [1:70] 0 0.000509 0.001037 0.001585 0.002154 ...
#>  $ i     : num [1:70] 0.0005 0.000524 0.000549 0.000576 0.000603 ...
#> $ f : num [1:70] 0.01 0.0102 0.0104 0.0106 0.0108 ...Qué vas a aprender
Esta guía explica qué calcula dismodlite y con qué supuestos, de la ecuación del modelo a los años vividos con discapacidad:
- el modelo enfermedad-muerte y la ecuación de la prevalencia;
- cómo se representan las tasas por edad (nudos e interpolación) y cómo se resuelve la ecuación;
- cómo entran al ajuste la estimación de referencia (el ancla), los priors y los datos locales;
- cómo se muestrea y qué son las simulaciones;
- cómo se lleva la estimación nacional a las ubicaciones subnacionales;
- cómo se calculan los AVD;
- los supuestos del modelo y sus límites.
La notación es la misma del código del paquete (la cabecera de su archivo R/edo.R), de modo que cada fórmula de esta guía se puede buscar en el código. Los cálculos de la guía son pequeños y corren en segundos.
Notación
| Símbolo | Significado | Unidades o dominio | En la configuración |
|---|---|---|---|
| edad | años, de a |
= edad_inicio; = 99 |
|
| , | personas sin y con la enfermedad (compartimentos) | personas | |
| prevalencia | proporción en | ||
| incidencia entre quienes no tienen la enfermedad () | por persona-año | ||
| remisión, de a | por persona-año | remision |
|
| mortalidad en exceso de quienes tienen la enfermedad (EMR) | por persona-año | mortalidad_exceso |
|
| mortalidad por otras causas | por persona-año; se cancela | ||
| ( en los nudos, en los nudos) | parámetros del muestreo | nudos |
|
| paso del método numérico, | años (0.2) | avanzado: {nsub: ...} |
|
| interpolación de los nudos a la malla | cada fila suma 1 | ||
| escala del prior de suavidad de | incidencia.suavidad |
||
| peso del ancla | ancla.peso |
||
| correlación entre bandas de edad del ancla | ancla.correlacion_edad |
||
| desplazamiento de la log-normal de los datos | avanzado: {offset_lognormal: ...} |
||
| fracción del gradiente subnacional que se aplica | subnacional.kappa |
Tres desviaciones estándar en escala logarítmica, ninguna de ellas : la del ancla, la del prior de la EMR y la de los datos locales. es la densidad normal con media y desviación estándar (nunca la varianza); es la normal multivariada con matriz de covarianza . Todas las tasas van por persona-año (no por 100 000) y la prevalencia es una proporción.
1. El modelo enfermedad-muerte
Cada persona de edad está sin la enfermedad () o con ella (). Quien no la tiene la adquiere con la tasa ; quien la tiene se cura con la tasa o muere por ella con la tasa , además de la mortalidad por otras causas , que afecta igual a los dos grupos. Al avanzar la edad:
La prevalencia es . Derivando el cociente, se cancela y queda una sola ecuación, la que resuelve el paquete:
Se lee así: la prevalencia sube con los casos nuevos entre quienes no tienen la enfermedad, , y baja con las remisiones, , y con las muertes en exceso. Esas muertes, por persona, quitan enfermos pero también reducen el total de personas; su efecto neto sobre la proporción es . Como afecta por igual a los dos grupos, no cambia la proporción y se cancela: el modelo no necesita la mortalidad general.
Tres decisiones completan el modelo:
-
Condición inicial: en =
edad_inicio. Se elige una edad a la que casi nadie tiene la enfermedad. -
Remisión: no se estima; es un dato de la configuración (
remision, 0 por defecto: una enfermedad crónica). Puede cambiar por tramos de edad conavanzado(ver?dl_configuracion). - Lo que se estima: la incidencia y la mortalidad en exceso . De ellas salen y las demás cantidades.
2. Las tasas por edad: nudos e interpolación
La incidencia y la mortalidad en exceso se describen por su valor en unas pocas edades, los nudos (nudos; por defecto cada 10 años desde edad_inicio hasta 80, y 95). Los parámetros del modelo son
los logaritmos de las dos tasas en los nudos. Entre nudos, y son lineales; fuera de ellos, constantes (antes del primer nudo valen lo del primero y después del último, lo del último). En una malla de edades, eso es una multiplicación por una matriz :
para entre y , con llevada primero al rango de los nudos. Cada fila de suma 1 y en un nudo devuelve su valor. Como es lineal, crece o decrece exponencialmente entre nudos.
La función exportada dl_edo() hace exactamente esto: recibe y en los nudos, interpola, resuelve la ecuación y devuelve , y en las edades enteras. Un ejemplo con valores inventados:
op <- par(mfrow = c(1, 2), mar = c(4, 4.2, 2.5, 1), oma = c(1.5, 0, 0, 0), las = 1)
plot(solucion$edades, 1000 * solucion$f, type = "l", lwd = 2, col = "#eb6834", log = "y", ylim = c(0.4, 100),
     yaxt = "n", xlab = "Edad (años)", ylab = "Por 1000 personas-año", main = "Tasas (escala logarítmica)",
     font.main = 1, bty = "n")
axis(2, at = c(0.5, 1, 2, 5, 10, 20, 50, 100), labels = c(0.5, 1, 2, 5, 10, 20, 50, 100))
lines(solucion$edades, 1000 * solucion$i, lwd = 2, col = "#2a78d6")
points(nudos, 1000 * exp(log_f), pch = 19, col = "#eb6834")
points(nudos, 1000 * exp(log_i), pch = 19, col = "#2a78d6")
legend("bottomright", c("Incidencia i", "Mortalidad en exceso f"), col = c("#2a78d6", "#eb6834"), lwd = 2,
       bty = "n", cex = 0.8)
plot(solucion$edades, 100 * solucion$p, type = "l", lwd = 2, col = "#1baf7a", xlab = "Edad (años)",
     ylab = "Prevalencia (%)", main = "Prevalencia p", font.main = 1, bty = "n")
mtext("Datos sintéticos: valores inventados para ilustrar", side = 1, outer = TRUE, adj = 1, cex = 0.75,
      col = "grey35")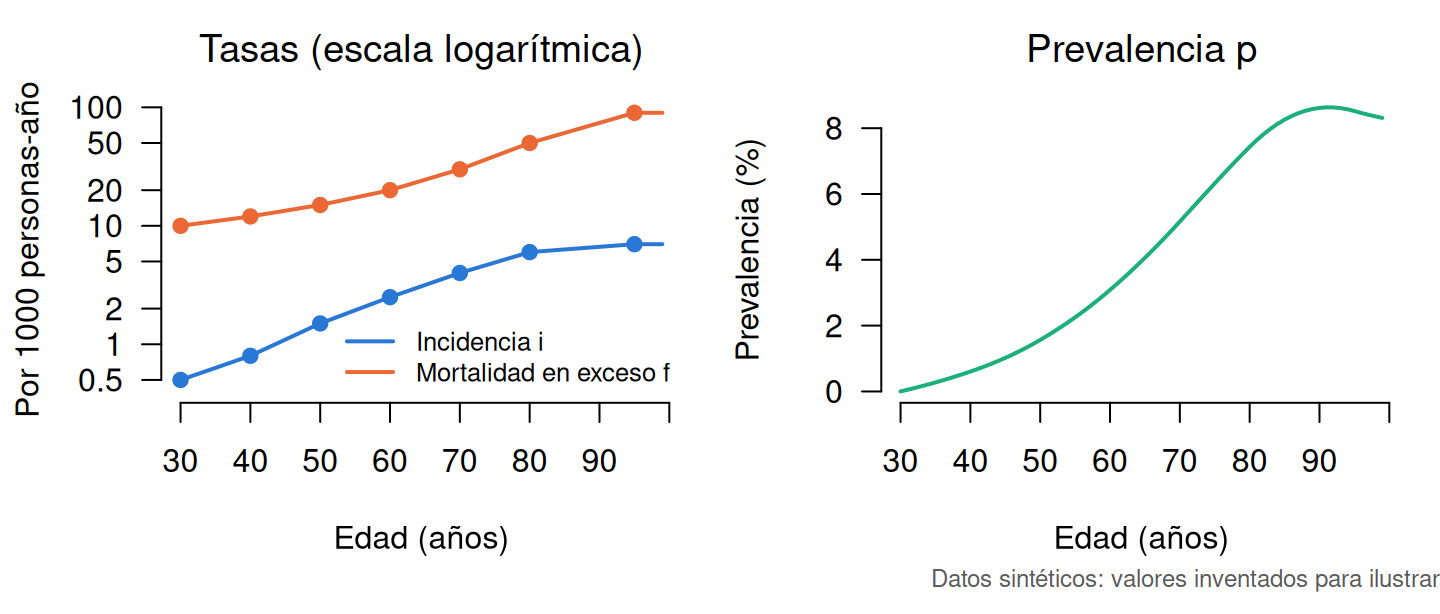
par(op)En escala logarítmica, las tasas son rectas entre nudos. La prevalencia crece mientras los casos nuevos superan a las muertes en exceso y se frena cuando aumenta.
3. Cómo se resuelve la ecuación
La ecuación de se integra con el método de Runge-Kutta de orden 4 (RK4), con paso de 0.2 años (, con pasos por año). Con y constantes y la ecuación tiene solución exacta, con y . Sirve para ver la precisión del método:
El error es muchísimo menor que la incertidumbre de cualquier estimación. Con una remisión o un techo de la mortalidad en exceso muy altos (enfermedades agudas) el paso de 0.2 años es demasiado largo para que el método sea estable: dl_insumos() lo comprueba y, si hace falta, se detiene y pide más pasos por año, que se declaran en avanzado (por ejemplo avanzado: {nsub: 10}, pasos de 0.1 años).
dl_edo() resuelve la ecuación por dentro; dl_edo_resolver() hace solo ese paso, a partir de las tasas ya evaluadas en la malla de edades, para quien quiera probar el método con otras tasas.
4. De las edades simples a las bandas de edad
Las estimaciones de referencia y los datos vienen por bandas de edad (40-44 años, 80 y más…). El modelo produce cantidades por edad simple y las lleva a cada banda con un promedio ponderado por la población:
donde es la población de la banda fina de la tabla de población que contiene la edad y , el número de edades del modelo que caen en esa banda (de todas las del modelo, no solo las del intervalo): cada edad lleva su parte de la población de su banda. Si el intervalo cabe en una sola banda, todas sus edades pesan igual; si cruza bandas con el mismo número de edades (varios quinquenios), se cancela y . Si cruza bandas con distinto número de edades (un dato de 60 años y más sobre bandas de cinco años y una de 80 y más), una banda completa cuenta por su población, no por su población multiplicada por su número de edades. La cantidad depende de lo que se compara:
| Medida | Qué es | |
|---|---|---|
| prevalencia | proporción con la enfermedad | |
| incidencia | casos nuevos por persona-año de toda la población | |
| mortalidad por la causa | muertes por la enfermedad por persona-año de toda la población |
La incidencia y la mortalidad se comparan por persona-año de toda la población, como las publica GBD. La banda abierta (por ejemplo, 95 años y más) se representa con las edades desde su inicio hasta 99.
5. La log-posterior: ancla, priors y datos
El ajuste combina cuatro fuentes de información, que se suman en la log-posterior de (por sexo):
Suavidad de la incidencia
Penaliza la curvatura de entre nudos (las segundas diferencias, sin dividir por la distancia entre nudos). Un mayor (incidencia.suavidad) permite una curva más quebrada. No dice nada sobre el nivel ni la pendiente de : esos los fija el ancla.
Prior de la mortalidad en exceso
Las muertes por la causa ocurren solo entre quienes la tienen, a la tasa ; por persona-año de toda la población son . De ahí , y el ancla, que trae la prevalencia y las muertes por banda, da un prior para en cada banda (mortalidad_exceso.prior: desde_ancla, el valor por defecto):
con la incertidumbre de las dos medidas del ancla. La fracción aguda (las muertes de la fase aguda de la enfermedad, que no son del modelo crónico) es 0 salvo que se declare (mortalidad_exceso.fraccion_aguda), y emr_prior.factor_sd puede ensanchar . Cada nudo toma el prior de la banda que lo contiene (un nudo fuera de las bandas del ancla toma la más cercana, con el doble de desviación estándar), y
Además, está acotada por un techo (mortalidad_exceso.techo; por defecto, 3 veces la mayor del ancla): fuera de la cota, la log-posterior es . Con mortalidad_exceso.prior: plano, y solo queda la cota, con uniforme entre y .
Para una causa que no aporta muertes, mortalidad_exceso.prior: cero fija y no la estima: es solo en los nudos, la ecuación se resuelve con () y , sin cota. No usa la mortalidad del ancla. Sin esta opción, una causa sin muertes dejaría sin información: sus cadenas recorrerían el prior y no convergerían. En la estimación subnacional, es 0 en toda ubicación.
Con mortalidad_exceso.prior: tabla, y no salen del ancla: son los del tramo de edad que contiene al nudo en la tabla prior_mortalidad_exceso del proyecto, por sexo. es el mismo término normal y queda bajo , como con el prior del ancla; es el centro de la Normal antes de truncarla y no puede superar . Sirve cuando la mortalidad en exceso se conoce por otra vía (un estudio de seguimiento, otra corrida, los años vecinos de un año sin muertes fiables).
El prior del ejemplo, en muertes por 1000 personas-año con la enfermedad (dl_prior_emr()):
insumos <- dl_insumos(dl_proyecto(dl_ejemplo(), causa = 9100))
prior <- dl_prior_emr(insumos)
prior$f_por_mil <- round(1000 * exp(prior$mu_log), 1)
head(prior[prior$sex_id == 1, c("age_start", "age_end", "mu_log", "sd_log", "f_por_mil")], 9)
#>    age_start age_end    mu_log   sd_log f_por_mil
#>        <num>   <num>     <num>    <num>     <num>
#> 1:        40      45 -4.253818 0.212132      14.2
#> 2:        45      50 -4.073958 0.212132      17.0
#> 3:        50      55 -3.946815 0.212132      19.3
#> 4:        55      60 -3.749431 0.212132      23.5
#> 5:        60      65 -3.528606 0.212132      29.3
#> 6:        65      70 -3.489496 0.212132      30.5
#> 7:        70      75 -3.335041 0.212132      35.6
#> 8:        75      80 -3.155352 0.212132      42.6
#> 9:        80      85 -2.889864 0.212132      55.6
El ancla
El ancla es la estimación de referencia de la prevalencia por banda de edad. Cada banda trae su valor y su intervalo del 95 %, que se lee como el de una normal en escala logarítmica: . Con la prevalencia del modelo en la banda (el promedio de la sección 4) y ,
-
(
ancla.correlacion_edad) correlaciona los errores de bandas vecinas: una estimación publicada no tiene errores independientes entre edades, y tratarlos como independientes le daría más información de la que tiene. Con , la correlación entre bandas a una, dos y tres de distancia es 0.5, 0.25 y 0.125:
La distancia se cuenta en bandas, no en años: con las bandas del ancla tal como vienen (80-84, 85-89, 90-94 y 95 y más, en vez de una sola de 80 y más), la misma correlaciona menos las edades altas que en la versión 1.0.0.
-
(
ancla.peso) multiplica la precisión del ancla (un power prior): con pesa entera; con cuenta como la mitad de la información. Se baja cuando los datos locales que entran al ajuste ya estaban en la estimación de referencia, para no contarlos dos veces.
En el ejemplo, las bandas del ancla de los hombres:
ancla <- insumos$prior_gbd
ancla <- ancla[ancla$sex_id == 1 & ancla$measure_id == 5, c("age_start", "age_end", "val", "lower", "upper",
                                                             "sigma_log")]
ancla
#>     age_start age_end        val       lower      upper sigma_log
#>         <num>   <num>      <num>       <num>      <num>     <num>
#>  1:        40      45 0.01202830 0.008964407 0.01613938      0.15
#>  2:        45      50 0.01801805 0.013428426 0.02417632      0.15
#>  3:        50      55 0.02543882 0.018958955 0.03413340      0.15
#>  4:        55      60 0.03206835 0.023899791 0.04302880      0.15
#>  5:        60      65 0.04099928 0.030555801 0.05501218      0.15
#>  6:        65      70 0.05542917 0.041310057 0.07437397      0.15
#>  7:        70      75 0.06804334 0.050711100 0.09129946      0.15
#>  8:        75      80 0.08157551 0.060796312 0.10945671      0.15
#>  9:        80      85 0.08837533 0.065864054 0.11858059      0.15
#> 10:        85      90 0.11608081 0.086512301 0.15575537      0.15
#> 11:        90      95 0.13296712 0.099097268 0.17841314      0.15
#> 12:        95     125 0.15371055 0.114556857 0.20624634      0.15
Los datos locales
Entran al ajuste las filas nacionales de la tabla datos del año que se estima, de los tipos de datos_en_ajuste y sin excluir. Cada dato se compara con la cantidad del modelo en su intervalo de edad (sección 4): para la prevalencia de un estudio, para la incidencia, para la mortalidad.
- Un dato con valor y error estándar entra con una log-normal: , con . El desplazamiento (0 por defecto) solo hace falta si algún valor es 0.
- Un dato con casos y muestra entra con su verosimilitud de conteos: binomial para la prevalencia ( casos entre personas), , y Poisson para la incidencia y la mortalidad ( eventos en personas-año), .
. Las constantes que no dependen de (la del truncamiento del prior de la EMR, de la binomial y de la Poisson) se omiten: el muestreo no las ve.
Dos consecuencias prácticas. Sin datos_en_ajuste (el valor por defecto), el ajuste queda informado por el ancla y los priors, y los datos locales solo validan. Y las covariables no entran al ajuste nacional: solo mueven las estimaciones subnacionales (sección 7).
6. El muestreo y las simulaciones
La posterior se recorre con un Metropolis-Hastings adaptativo por bloques, por sexo: un bloque para y otro para en los nudos. En cada iteración se propone mover un bloque, con , y se acepta con probabilidad . Durante el calentamiento el muestreador adapta la escala (hacia una aceptación de 0.28) y la forma (la covarianza de las iteraciones de la primera mitad del calentamiento); después las deja fijas y guarda una de cada adelgazamiento iteraciones. Cada cadena usa una semilla derivada de la semilla del ajuste: el resultado es el mismo en serie o en paralelo.
Cada vector guardado es una simulación: con él se resuelve la ecuación y se obtienen , y por edad. Las estimaciones son la media de las simulaciones y su intervalo del 95 %, los percentiles 2.5 y 97.5. La media es lineal, así que las sumas son exactas: las ubicaciones subnacionales suman la nacional y los subtipos suman la causa que los contiene.
La convergencia se mide con el R-hat partido (Gelman y colaboradores) y el tamaño efectivo de muestra (ESS). Una corrida de producción exige R-hat < 1.01 y ESS ≥ 400 en todos los parámetros.
El muestreador está exportado para quien quiera usarlo con otra log-posterior: dl_mh() corre una cadena y dl_mh_cadenas() varias, en serie o en paralelo, cada una con una semilla derivada de la que recibe. dl_ajustar() los usa con la log-posterior de la sección 5.
7. De lo nacional a lo subnacional
La estimación subnacional (subnacional.modo: covariables) desplaza las tasas nacionales de cada ubicación según la diferencia entre sus covariables y las nacionales, con los coeficientes publicados (, en la tabla betas). Para cada sexo y cada simulación :
-
Diferencia de la covariable. Con la transformación de la covariable (log, logit o lineal), el valor nacional , con , y el de la ubicación , , con del error estándar de su fila en la tabla
covariablespor el método delta. La diferencia es (escala, solo con la transformación lineal), por banda de edad del proxy. -
Desplazamiento. Con , , y el peso de la banda del proxy en la edad (interpolación lineal entre los puntos medios de las bandas), donde las covariables con
efecto_sobre: prevalenciaoincidenciamueven y las demortalidad_excesomueven . (subnacional.kappa) es la fracción del gradiente que se aplica. - Nueva solución: se resuelve con y , con la misma remisión.
- Renormalización, por sexo, banda de población y simulación, para y : de modo que la suma ponderada por población de las ubicaciones es exactamente la nacional. Si algún queda fuera de , es un error.
Con subnacional.modo: plano, cada ubicación recibe las tasas nacionales. Con subnacional.modo: razon también, y después de los AVD cada medida (prevalencia, incidencia y AVD por banda) se reparte con la razón de cada ubicación (tabla razones): con y , una vez por ubicación y simulación (la misma en todas las edades, los dos sexos y las tres medidas), de modo que la suma ponderada por población de las ubicaciones es exactamente la nacional (dl_repartir_razon()). Los datos subnacionales de la tabla datos del año subnacional.anio_validacion no entran al ajuste: los de mortalidad sirven para validar la estimación subnacional (dl_validar_ancla()).
8. Carga: años vividos con discapacidad
Los AVD por persona de cada banda de edad y simulación son
donde es la prevalencia de la banda, la proporción de los casos en el estado de salud y su peso de discapacidad (de la tabla severidad). Cada proporción y cada peso se simula con una distribución Beta con la media y la varianza de su intervalo del 95 %, ; las proporciones se renormalizan para que sumen 1 en cada simulación.
calibra el resultado a los AVD del ancla: . Absorbe la corrección por comorbilidad y el patrón por edad de la severidad (la tabla de severidad es la misma a todas las edades); puede superar 1. Los AVD de la fórmula son años vividos con discapacidad por persona y año, en la misma escala que (por 100 000, multiplicados por 100 000).
9. Supuestos y límites
- Estado estacionario. El modelo relaciona tasas y prevalencia a lo largo de la edad en un año, como si las tasas de hoy se hubieran mantenido toda la vida de cada cohorte. Con tendencias fuertes en el tiempo la relación entre incidencia y prevalencia se distorsiona.
-
Nadie tiene la enfermedad en
edad_inicio() y la mortalidad por otras causas es igual con y sin la enfermedad (por eso se cancela). - Remisión conocida: no se estima.
- Formas por edad: y son lineales entre nudos y constantes fuera de ellos; el modelo no puede mostrar rasgos más finos que los que permiten los nudos.
-
El ancla es la fuente principal. Su incertidumbre se resume en una log-normal por banda con correlación AR(1) entre bandas, una simplificación de la publicada. Si los datos locales ya informaron el ancla, hay que bajar y dejar la razón en
notas. - Solo datos nacionales en el ajuste. Los subnacionales validan, no ajustan.
- Diferencias subnacionales solo por covariables. Se supone que la asociación publicada entre la covariable y la tasa vale entre las ubicaciones del país (un supuesto ecológico), atenuada por ; no hay efectos aleatorios por ubicación. La renormalización impone el total nacional desde arriba.
- Severidad igual en todas las edades y ubicaciones, con los pesos de discapacidad simulados de forma independiente entre estados; es una calibración empírica.
- El estimador puntual es la media de las simulaciones.
Cada corrida registra en su manifiesto sus limitaciones y las claves tomadas por defecto, y las etiquetas (dl_etiquetas()) dicen, celda por celda, si el resultado lo mueven los datos o el ancla.
Siguientes pasos
- Primeros pasos: el modelo en acción con el proyecto de ejemplo.
- Preparar tus datos: qué va en cada archivo y en qué unidades.
- En el sitio del paquete (https://horaciochacon.github.io/dismodlite/), las guías Estimación subnacional, Datos locales, Carga: los años vividos con discapacidad y Diagnóstico y sensibilidad.
- La ayuda de cada función (
?dl_edo,?dl_prior_emr,?dl_cascada,?dl_avd) describe lo que calcula.