
Convierte un indicador de encuesta ya agregado por ubicación subnacional y edición (la tabla proxies_crudos)
en las filas subnacionales de la tabla covariables para el año que se estima: cada ubicación conserva su
posición relativa en la encuesta y el promedio ponderado por la población cierra exactamente en el valor
nacional de la covariable, que sigue en covariables.
Usage
dl_calibrar_proxies(
  crudos,
  covariables,
  poblacion,
  anio,
  metodo = c("paseo_aleatorio", "edicion"),
  transformacion = NULL,
  excluir = NULL,
  anio_nacional = anio,
  ubicacion_gbd = NULL,
  valor_nacional_de = NULL
)
Arguments
- crudos
Tabla
proxies_crudos(ver dl_tablas):data.frameo ruta de un CSV o una carpeta.- covariables
Tabla
covariables, con el valor nacional de cada covariable de los crudos (o de la que nombravalor_nacional_de).- poblacion
Tabla
poblacionde las ubicaciones de los crudos; sus bandas de edad (y sus sexos, para «ambos») deben poder sumarse en las de los crudos. Una fila de los crudos sin edades (o sin las columnas de edad, o con la banda de 0 y más) es de todas las edades: su población es la de todas las bandas depoblacion, empiecen donde empiecen.- anio
Año que se estima: el de las filas que salen.
- metodo
Método temporal:
"paseo_aleatorio"(por defecto) o"edicion".- transformacion
Vector (o lista) con nombres, covariable =
"cociente"o"diferencia". Las covariables que no nombra usan"cociente".- excluir
data.frameconanioymotivo: ediciones que no entran. Cada una necesita su motivo.- anio_nacional
Año del valor nacional que cierra las filas. Por defecto,
anio.- ubicacion_gbd
location_idde GBD del país, para leercovariablescuando es una carpeta (o un CSV) de descargas del GHDx con varias ubicaciones, como la carpetacovariables/de un proyecto (verdl_tabla()). No hace falta sicovariablesya es una tabla leída.- valor_nacional_de
Vector (o lista) con nombres, covariable de los crudos = la covariable de
covariablescuyo valor nacional cierra sus filas. Las covariables que no nombra cierran en su propio valor nacional.
Value
Una dl_tabla() covariables con las filas subnacionales del año: ubicacion, anio, sexo, las
edades (si los crudos las traen; vacías en las de todas las edades), covariable, valor, error_estandar y
fuente (el indicador, el método, q y las ediciones de la serie). Tres atributos:
calibracion: undata.tablepor covariable conmetodo,transformacion,q,q_en_borde(el borde de su intervalo de búsqueda en que quedó q,"inferior"o"superior";NAsi no quedó en ninguno o no hay q),ediciones(las usadas: con el paseo aleatorio, todas las no excluidas; conedicion, las elegidas en alguna serie),excluidas(en texto, con su motivo),anios_poblacion(el año de la población de cada edición y del cierre) yvalor_nacional_de(la covariable que dio el valor nacional, si es otra; si no, vacío).series: undata.tablepor serie y edición cong,se_g,g_suavizadoyS(el gradiente suavizado y su varianza en el año de la edición; conedicion, g y se_g²) yusada(la edición que tomóedicion; con el paseo aleatorio entran todas). Sin edades en los crudos, la banda es 0-125 (todas las edades).excluidas: undata.tableconcovariable,anioymotivo, una fila por edición excluida de cada covariable (sin filas si no se excluyó ninguna).
Details
Gradiente de cada edición. Por covariable, sexo, banda de edad y edición t, el gradiente de la ubicación d
compara su valor con \(\bar p_t\), el promedio de esa edición ponderado por la población del año de poblacion más
cercano a t (con dos igual de cerca, el anterior). \(\bar p_t\) se toma sobre las ubicaciones comunes, las que están
en todas las ediciones: así la referencia no se mueve cuando una edición no trae todas las ubicaciones. Si las
ediciones no traen las mismas ubicaciones, la función avisa cuáles faltan; si menos de dos están en todas, es un
error (excluye las ediciones con menos ubicaciones).
cociente: \(g = \log(p / \bar p_t)\), con error se / p (aproximación delta de la escala log). Para indicadores positivos que se comparan en proporción (prevalencias, tasas); exige valores mayores que 0.diferencia: \(g = p - \bar p_t\), con error se. Para índices en los que importa la distancia en puntos (como un índice de 0 a 100) o indicadores que pueden valer 0.
Gradiente del año que se estima.
edicion: el de la edición del año o, si no hay, el de la más cercana (con dos igual de cerca, la anterior), con su varianza se_g².paseo_aleatorio: cada serie (covariable, ubicación, sexo y banda) sigue un paseo aleatorio, \(g_t = g_{t-1} + \eta_t\) con \(\eta_t \sim N(0, q \Delta t)\), observado con su error. Un filtro de Kalman y un suavizador RTS dan el gradiente en el año que se estima, haya o no edición ese año, usando todas las ediciones de la serie. q, la varianza por año del gradiente, se estima por máxima verosimilitud, una por covariable con todas sus series.
Cómo leer q. Su raíz es cuánto se mueve el gradiente en un año (en log con cociente, en las unidades del
indicador con diferencia). Con q muy chico el gradiente es casi constante y el resultado es la media de las
ediciones ponderada por 1/se²; con q grande cada edición manda y el resultado se acerca al de edicion. q se busca
entre \(10^{-6}\bar\sigma^2\) y \(10^{3}\bar\sigma^2\), con
\(\bar\sigma^2\) la mediana de se_g² de la covariable: un intervalo relativo al error de las ediciones,
así que el resultado no depende de las unidades del indicador (con diferencia, el mismo índice multiplicado por
100 da los mismos valores por 100 y q por \(10^4\)). Si q queda
en un borde de ese intervalo, calibracion dice cuál (q_en_borde: "inferior" o "superior"): en el
inferior (gradiente estable) la función lo informa con un mensaje; en el superior (cada edición manda) avisa.
Con pocas ediciones la verosimilitud de q es plana: q puede moverse órdenes de magnitud con una edición más o
menos. Es el grado de suavizado que eligen estos datos, no una propiedad estable del indicador: no lo compares
entre encuestas ni lo leas por sí solo. Si
todas las series de una covariable tienen una sola edición, q no se puede estimar: se usa la edición de cada serie, con un
aviso, y q es NA. Una serie con una sola edición entre otras que sí estiman q coincide con edicion solo en
el año de esa edición; en otro año su varianza suma \(q |\Delta t|\).
Cierre. Por sexo y banda, con w_d la población de cada ubicación en el año de poblacion más cercano a anio
y X el valor nacional:
cociente: \(X_d = X e^{\hat g_d} / \sum_d w_d e^{\hat g_d}\) (con los w_d normalizados para sumar 1), con error \(X_d \sqrt{S_d}\);diferencia: \(X_d = X + \hat g_d - \sum_d w_d \hat g_d\), con error \(\sqrt{S_d}\).
\(\sum_d w_d X_d / \sum_d w_d = X\) por construcción. El valor nacional es la fila de covariables de la covariable sin
ubicacion (o con una que no está en los crudos), del año anio_nacional, del mismo sexo o de ambos y de la misma
banda o de todas las edades; gana la que coincide en más.
El valor nacional de otra covariable. A veces el valor nacional con que se compara una covariable es el de
otra: una beta estimada por edad cuyos valores subnacionales se comparan con la versión estandarizada por edad de
la misma covariable. valor_nacional_de lo dice, covariable de los crudos = covariable de covariables: X es
entonces el valor nacional de la covariable nombrada, que se busca con las mismas reglas, y la propia no necesita
fila nacional. Las filas que salen llevan el nombre de la covariable de los crudos. En un proyecto es la columna
valor_nacional_de de la tabla betas (dl_tablas), y dl_proyecto() la pasa a la calibración (en un proyecto,
la beta queda eximida de su fila nacional solo si su covariable tiene valores subnacionales, en covariables o en
proxies_crudos).
Aproximaciones declaradas. El error de X_d no incluye la incertidumbre de la normalización ni la del valor
nacional; se/p es la aproximación delta; la población de cada edición (y la del cierre) es la del año más cercano
de poblacion, también fuera de sus años (calibracion$anios_poblacion dice cuál se usó). Una ubicación que falta
en una edición se interpola con sus otras ediciones (con edicion, se usa su edición más cercana).
See also
dl_tablas (la tabla proxies_crudos), dl_tabla(), dl_proyecto().
Funciones del proyecto:
dl_correr(),
dl_ejemplo(),
dl_nuevo_proyecto(),
dl_plantilla(),
dl_proyecto(),
dl_revisar_proyecto(),
dl_tabla(),
dl_tablas
Examples
pob <- data.frame(ubicacion = rep(c("R01", "R02", "R03"), each = 2),
anio = rep(c(2019, 2023), 3),
sexo = "ambos", edad_inicio = 0, edad_fin = NA,
poblacion = c(100, 110, 300, 290, 200, 210))
crudos <- data.frame(ubicacion = rep(c("R01", "R02", "R03"), 3),
anio = rep(c(2019, 2021, 2023), each = 3),
covariable = "haqi", indicador = "índice de acceso (encuesta)",
valor = c(40, 60, 52, 45, 58, 50, 41, 63, 55), error_estandar = 1.5)
nacional <- data.frame(anio = 2023, covariable = "haqi", valor = 56.4)
cal <- dl_calibrar_proxies(crudos, nacional, pob, anio = 2023,
transformacion = c(haqi = "diferencia"))
cal
#> ubicacion anio sexo covariable valor error_estandar
#> <char> <int> <char> <char> <num> <num>
#> 1: R01 2023 ambos haqi 42.52542 1.316869
#> 2: R02 2023 ambos haqi 62.81241 1.316869
#> 3: R03 2023 ambos haqi 54.81241 1.316869
#> fuente
#> <char>
#> 1: índice de acceso (encuesta): calibrado (paseo_aleatorio, q = 2.9, ediciones 2019, 2021, 2023)
#> 2: índice de acceso (encuesta): calibrado (paseo_aleatorio, q = 2.9, ediciones 2019, 2021, 2023)
#> 3: índice de acceso (encuesta): calibrado (paseo_aleatorio, q = 2.9, ediciones 2019, 2021, 2023)
attr(cal, "calibracion")
#> covariable metodo transformacion q q_en_borde
#> <char> <char> <char> <num> <char>
#> 1: haqi paseo_aleatorio diferencia 2.902516 <NA>
#> ediciones excluidas
#> <char> <char>
#> 1: 2019, 2021, 2023
#> anios_poblacion
#> <char>
#> 1: ediciones: 2019 → 2019, 2021 → 2019, 2023 → 2023; cierre: 2023 → 2023
#> valor_nacional_de
#> <char>
#> 1: <NA>
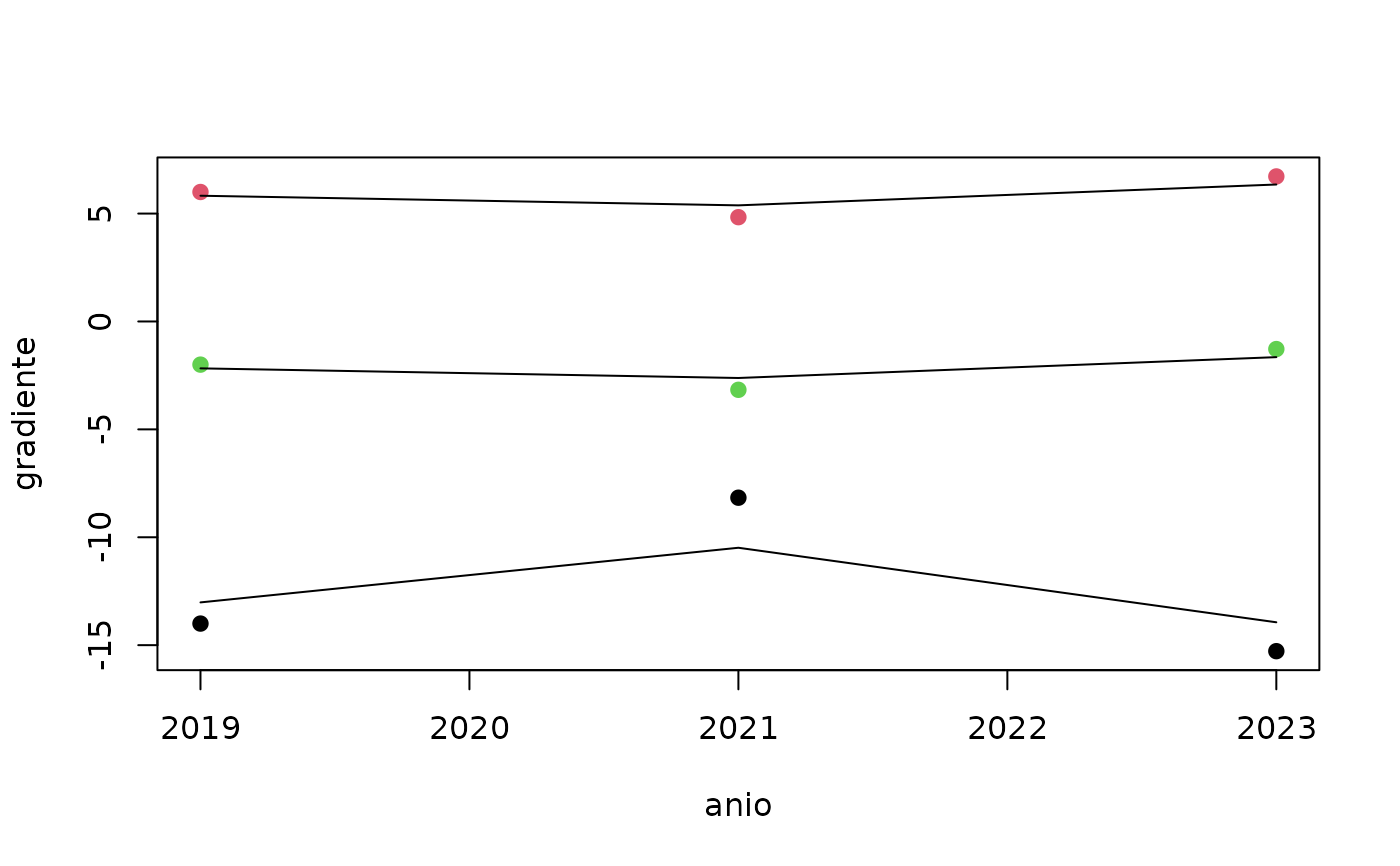
# las series: gradiente observado (puntos) y suavizado (líneas), por ubicación
s <- attr(cal, "series")
plot(g ~ anio, s, col = factor(ubicacion), pch = 19, ylab = "gradiente")
for (u in unique(s$ubicacion)) lines(g_suavizado ~ anio, s[s$ubicacion == u, ])
 # el valor nacional de otra covariable: las filas de haqi cierran en el de haqi_estandarizado
otra <- data.frame(anio = 2023, covariable = "haqi_estandarizado", valor = 54.1)
cal2 <- dl_calibrar_proxies(crudos, otra, pob, anio = 2023,
transformacion = c(haqi = "diferencia"),
valor_nacional_de = c(haqi = "haqi_estandarizado"))
weighted.mean(cal2$valor, c(110, 290, 210)) # 54.1
#> [1] 54.1
attr(cal2, "calibracion")$valor_nacional_de
#> [1] "haqi_estandarizado"
# el proyecto de ejemplo trae una encuesta de tres ediciones: dl_proyecto() la calibra
p <- dl_proyecto(dl_ejemplo(), causa = 9100)
attr(p$calibracion, "calibracion")[, c("covariable", "transformacion", "q", "ediciones")]
#> covariable transformacion q ediciones
#> <char> <char> <num> <char>
#> 1: SEV_scalar_agestd_cvd_pvd cociente 2.255044e-05 2019, 2021, 2023
#> 2: LDI_pc cociente 3.734479e-04 2019, 2021, 2023
#> 3: haqi diferencia 4.055032e-01 2019, 2021, 2023
# la misma calibración a mano, para otro año, con el método de la edición más cercana
t <- p$tablas
cal19 <- dl_calibrar_proxies(t$proxies_crudos, t$covariables, t$poblacion, anio = 2019,
metodo = "edicion", transformacion = c(haqi = "diferencia"))
head(cal19)
#> ubicacion anio sexo edad_inicio edad_fin covariable
#> <char> <int> <char> <num> <num> <char>
#> 1: 01 2019 hombres 40 45 SEV_scalar_agestd_cvd_pvd
#> 2: 02 2019 hombres 40 45 SEV_scalar_agestd_cvd_pvd
#> 3: 03 2019 hombres 40 45 SEV_scalar_agestd_cvd_pvd
#> 4: 04 2019 hombres 40 45 SEV_scalar_agestd_cvd_pvd
#> 5: 05 2019 hombres 40 45 SEV_scalar_agestd_cvd_pvd
#> 6: 06 2019 hombres 40 45 SEV_scalar_agestd_cvd_pvd
#> valor error_estandar
#> <num> <num>
#> 1: 1.188649 0.03139827
#> 2: 1.152765 0.02790957
#> 3: 1.214565 0.03239504
#> 4: 1.256927 0.02940473
#> 5: 1.214066 0.03139827
#> 6: 1.102926 0.02591603
#> fuente
#> <char>
#> 1: indicador sintético de riesgo vascular (proporción): calibrado (edicion, ediciones 2019)
#> 2: indicador sintético de riesgo vascular (proporción): calibrado (edicion, ediciones 2019)
#> 3: indicador sintético de riesgo vascular (proporción): calibrado (edicion, ediciones 2019)
#> 4: indicador sintético de riesgo vascular (proporción): calibrado (edicion, ediciones 2019)
#> 5: indicador sintético de riesgo vascular (proporción): calibrado (edicion, ediciones 2019)
#> 6: indicador sintético de riesgo vascular (proporción): calibrado (edicion, ediciones 2019)