
library(dismodlite)
proyecto <- dl_ejemplo(copiar_en = file.path(tempdir(), "mi_proyecto"))
list.files(proyecto)
#>  [1] "ancla"              "betas.csv"          "config"
#>  [4] "covariables"        "datos.csv"          "LEEME.md"
#>  [7] "poblacion.csv"      "proxies_crudos.csv" "severidad.csv"
#> [10] "ubicaciones.csv" "verdad.csv"Qué vas a aprender
- Qué hace
dl_correr()y qué deja en la carpeta de una corrida. - Cómo se nombran las corridas y cómo conviven sus versiones.
- Cómo volver a resumir una corrida desde sus simulaciones, sin volver a ajustar.
- Cómo estimar otro año o varios (
anios) sin editar la configuración, y cómo se proyecta un año que todavía no tiene estimación de referencia. - Cómo correr todas las causas de un proyecto.
- Qué es el registro de corridas y cómo se arman las tablas consolidadas con un perfil de columnas.
- Cómo dejar la incidencia de una causa fuera de las tablas consolidadas y cómo consolidar una causa con subtipos desde su propio ajuste.
Todo el recorrido usa el proyecto de ejemplo, con datos sintéticos, y corridas de prueba (rapido = TRUE) que tardan segundos. Sus cadenas son cortas y no convergen: los números sirven para ver la forma de los resultados, no para publicar. Para la corrida de producción, y cuánto tarda, ver Diagnóstico y sensibilidad.
Una corrida en una llamada
dl_correr() escribe sus resultados dentro de la carpeta del proyecto (en resultados/). El proyecto de ejemplo está dentro de la instalación del paquete, que no es un lugar para escribir, así que primero lo copiamos a una carpeta temporal, como harías para empezar un proyecto propio a partir del ejemplo:
Una corrida de prueba de la causa 9100, sin el análisis de sensibilidad:
corrida <- dl_correr(proyecto, causa = 9100, semilla = 1, rapido = TRUE, sensibilidad = FALSE)
#> dl_correr(): corrida de prueba (rapido = TRUE): 2 cadena(s) de 2000 iteraciones y forzar = TRUE, que la escribe aunque las cadenas no converjan. Sus números no sirven para publicar: para la corrida final, rapido = FALSE
#> dl_correr(): causa 9100: insumos
#> dl_correr(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
#> dl_correr(): ajuste nacional: 2 cadena(s) de 2000 iteraciones por sexo (motor mh)
#> dl_correr(): cascada subnacional
#> dl_correr(): validación contra el ancla y AVD
#> dl_correr(): etiquetas de cuánto informan los datos
#> dl_correr(): corrida escrita en /tmp/RtmpMPrJGj/mi_proyecto/resultados/mod/dismod_lite/2026-10-15_causa-9100-prueba_v1 (prueba: no sirve para publicar)
corrida
#> <dl_run> corrida 2026-10-15_causa-9100-prueba_v1 (cascada subnacional)
#>   carpeta: /tmp/RtmpMPrJGj/mi_proyecto/resultados/mod/dismod_lite/2026-10-15_causa-9100-prueba_v1
#>   3 particiones canónicas (una por medida) | exportada con forzar = TRUE
Los mensajes siguen los pasos de la corrida: los insumos, el ajuste nacional, la estimación subnacional, la validación, los AVD, las etiquetas, la sensibilidad y la escritura. Cada paso es una función del paquete que también puedes llamar por separado; ?dl_correr los lista en orden, con la función de cada uno. La corrida de producción es la misma llamada sin rapido:
corrida <- dl_correr(proyecto, causa = 9100, semilla = 1)Usa las cadenas de producción (1000 simulaciones, 4 cadenas de 50 000 iteraciones) y corre la sensibilidad: en el ejemplo tarda unos 5 minutos. Antes de escribir nada comprueba que las cadenas convergieron y que la prevalencia ajustada reproduce la del ancla, las dos compuertas de una corrida; la corrida de prueba salta la primera y lo declara en el manifiesto.
Para mirar una corrida de producción cuyas cadenas todavía no convergen, forzar = TRUE la escribe igual: salta solo la compuerta de la convergencia (la del ancla, nunca), un mensaje da el R-hat y el ESS de las cadenas y el manifiesto lo declara (validacion.gates.force). Sus números no sirven para publicar.
corrida <- dl_correr(proyecto, causa = 9100, semilla = 1, forzar = TRUE)La carpeta de la corrida
Una corrida se escribe en <carpeta_salida>/mod/dismod_lite/<run_id>/. Por defecto, carpeta_salida es la carpeta resultados del proyecto; con el argumento carpeta_salida se escribe en otra parte. mod/dismod_lite/ es la subcarpeta fija de las corridas del modelo, la misma desde la versión 0.2.2.
corrida$dir
#> [1] "/tmp/RtmpMPrJGj/mi_proyecto/resultados/mod/dismod_lite/2026-10-15_causa-9100-prueba_v1"
list.files(corrida$dir, recursive = TRUE)
#>  [1] "cause/incidence/2026-10-15_causa-9100-prueba_v1.csv"
#>  [2] "cause/prevalence/2026-10-15_causa-9100-prueba_v1.csv"
#>  [3] "cause/yld/2026-10-15_causa-9100-prueba_v1.csv"
#>  [4] "diagnostics/aceptacion.csv"
#>  [5] "diagnostics/amplitud.csv"
#>  [6] "diagnostics/desplazamiento_splits.csv"
#>  [7] "diagnostics/dx_bandas.csv"
#>  [8] "diagnostics/mcmc.csv"
#>  [9] "diagnostics/proxies_series.csv"
#> [10] "diagnostics/renorm.csv"
#> [11] "diagnostics/validacion.csv"
#> [12] "draws/incidence_2023.csv.gz"
#> [13] "draws/prevalence_2023.csv.gz"
#> [14] "draws/yld_2023.csv.gz"
#> [15] "etiquetas/2026-10-15_causa-9100-prueba_v1.csv"
#> [16] "inputs/betas.csv"
#> [17] "inputs/config_usado.yaml"
#> [18] "inputs/contrato/ancla.csv"
#> [19] "inputs/contrato/betas.csv"
#> [20] "inputs/contrato/config.yaml"
#> [21] "inputs/contrato/covariables.csv"
#> [22] "inputs/contrato/datos.csv"
#> [23] "inputs/contrato/poblacion.csv"
#> [24] "inputs/contrato/proxies_crudos.csv"
#> [25] "inputs/contrato/severidad.csv"
#> [26] "inputs/contrato/ubicaciones.csv"
#> [27] "inputs/cov_proxy.csv"
#> [28] "inputs/cov_valores.csv"
#> [29] "inputs/crosswalks.csv"
#> [30] "inputs/datos.csv"
#> [31] "inputs/hash.json"
#> [32] "inputs/poblacion.csv"
#> [33] "inputs/prior_gbd.csv"
#> [34] "inputs/sequela_map.csv"
#> [35] "inputs/severidad.csv"
#> [36] "manifest.yaml"| Archivo o carpeta | Qué contiene |
|---|---|
manifest.yaml |
La descripción de la corrida: causa, año, parámetros del modelo y del muestreo, semilla, insumos (con el sha256 de cada tabla), estimación subnacional, datos usados, notas de la configuración, claves tomadas por defecto, resultado de las compuertas y de la validación, y limitaciones. |
cause/<medida>/<run_id>.csv |
Las estimaciones: una fila por ubicación, sexo y grupo de edad, para la prevalencia, la incidencia y los AVD, con los nombres de columna de las descargas de GBD. |
draws/<medida>_<año>.csv.gz |
Las simulaciones de cada celda (una columna por simulación), comprimidas. |
etiquetas/<run_id>.csv |
Cuánto informan los datos locales cada celda (ver Diagnóstico y sensibilidad). |
diagnostics/ |
R-hat y tamaño efectivo por parámetro (mcmc.csv), tasas de aceptación (aceptacion.csv), validación contra el ancla (validacion.csv, amplitud.csv), factores de renormalización y diferencias de las covariables de la estimación subnacional (renorm.csv, dx_bandas.csv), la razón aplicada por ubicación en el reparto por razón (razon.csv), el desplazamiento de las proporciones de severidad (desplazamiento_splits.csv) y, si se corrió, la sensibilidad (sensibilidad.csv). |
inputs/ |
Los insumos congelados, tal como entraron al modelo (las tablas en CSV, hash.json, la configuración usada y las descargas de covariables): con ellos la corrida se puede reproducir y auditar. En inputs/contrato/, las tablas del contrato y la configuración del proyecto tal como se leyeron (las betas, solo las que usó la causa: las de su causa padre, si es un subtipo sin betas propias): es la carpeta de un proyecto, y dl_proyecto(file.path(run$dir, "inputs", "contrato")) repite la corrida. La carpeta de una partición de severidad (severidad.particion) se congela también, en inputs/contrato/particion/<corrida>/, con la ruta de la configuración congelada cambiada a ella y el sha256 de cada archivo en el manifiesto (la tabla severidad, que sale de ella, no se congela aparte). |
Las estimaciones de cada medida son una tabla plana:
celdas <- read.csv(file.path(corrida$dir, "cause", "prevalence", paste0(corrida$run_id, ".csv")),
                   colClasses = c(location_id = "character"))
head(celdas[, c("location_id", "location_name", "sex_id", "age_group_name", "metric_name",
                "val", "lower", "upper")])
#>   location_id location_name sex_id age_group_name metric_name        val
#> 1         123          Perú      1    40-44 years     Percent 0.01274434
#> 2         123          Perú      1    45-49 years     Percent 0.01897328
#> 3         123          Perú      1    50-54 years     Percent 0.02581334
#> 4         123          Perú      1    55-59 years     Percent 0.03340600
#> 5         123          Perú      1    60-64 years     Percent 0.04196389
#> 6         123          Perú      1    65-69 years     Percent 0.05226160
#>         lower      upper
#> 1 0.009321281 0.01653482
#> 2 0.015643420 0.02291474
#> 3 0.021226377 0.03130308
#> 4 0.027504514 0.04002152
#> 5 0.034660406 0.05038544
#> 6 0.043213559 0.05996622
val es la media de las simulaciones y lower y upper, sus cuantiles 2.5 % y 97.5 %. La prevalencia va como proporción de la población, entre 0 y 1 (con la métrica Percent, como en las versiones anteriores); la incidencia y los AVD, como tasa por 100 000 (métrica Rate). Las filas de nivel 0 son las nacionales y las de nivel 1, las subnacionales:
mujeres <- celdas[celdas$sex_id == 2 & celdas$age_group_id == 18, ]   # mujeres de 65 a 69 años
nacional <- mujeres[mujeres$location_level == 0, ]
subnacional <- mujeres[mujeres$location_level == 1, ]
subnacional <- subnacional[order(subnacional$val), ]
k <- seq_len(nrow(subnacional))
op <- par(mar = c(5, 9, 4.5, 1))
plot(100 * subnacional$val, k, xlim = 100 * range(subnacional$lower, subnacional$upper), pch = 19, yaxt = "n",
     xlab = "Prevalencia (%)", ylab = "", main = "Mujeres de 65 a 69 años, 2023 (corrida de prueba)",
     sub = "Datos sintéticos")
segments(100 * subnacional$lower, k, 100 * subnacional$upper, k)
axis(2, at = k, labels = subnacional$location_name, las = 1, cex.axis = 0.7)
abline(v = 100 * nacional$val, lty = 2)
mtext("punto: media; línea: intervalo del 95 %; línea discontinua: nacional", side = 3, line = 0.5, cex = 0.8)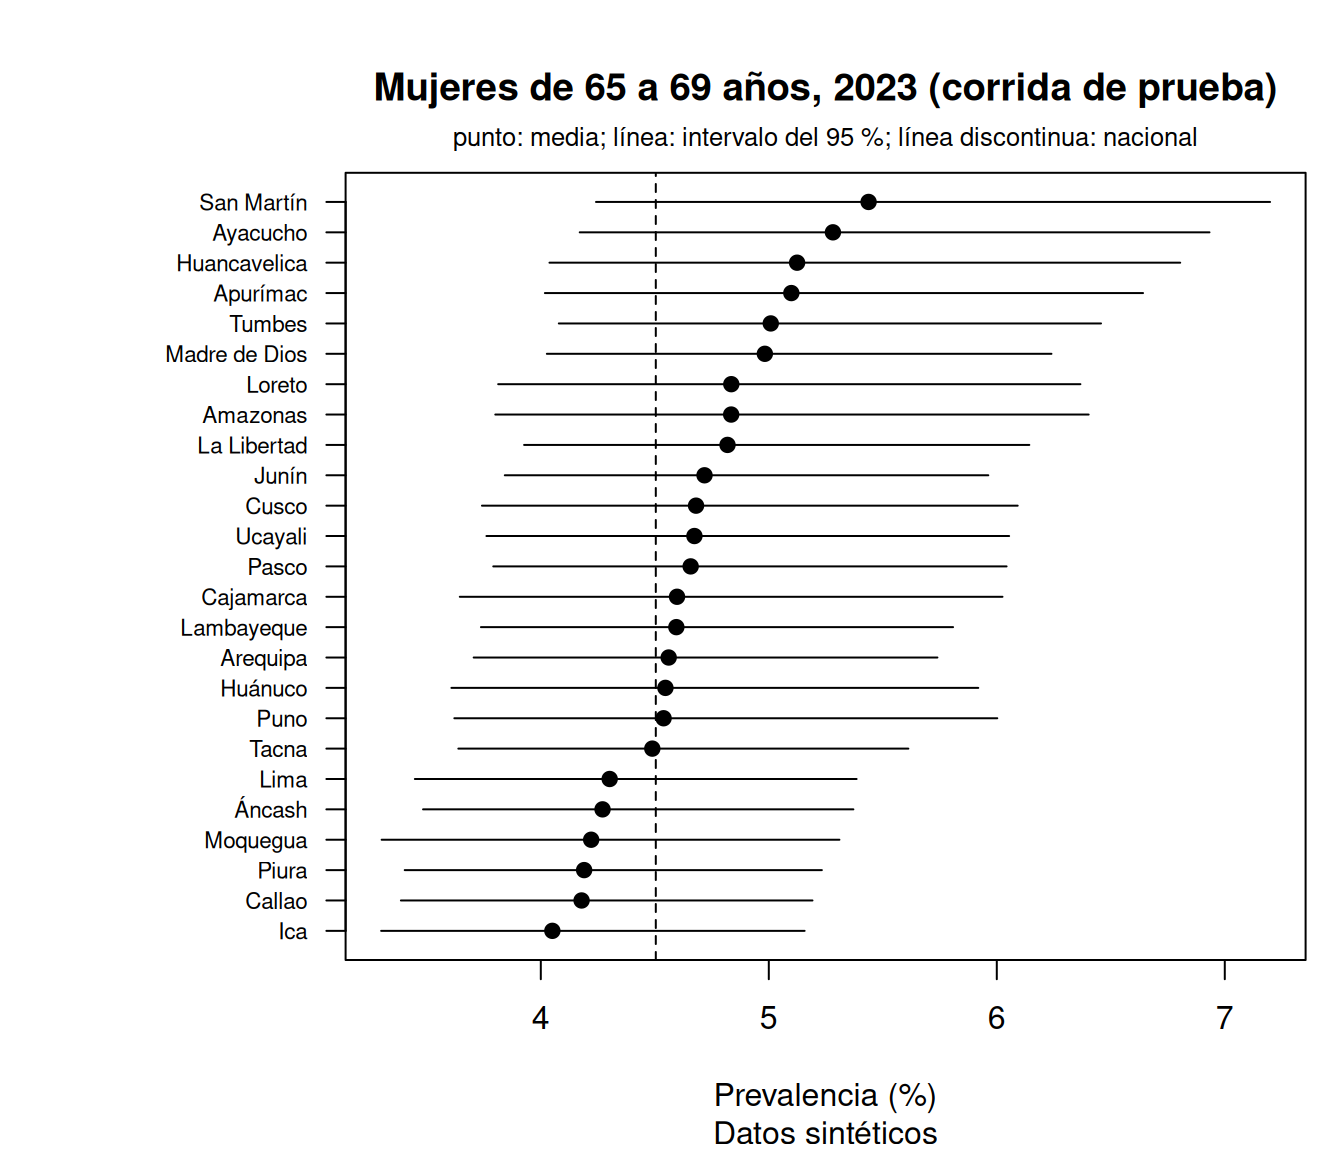
par(op)Las simulaciones de cada celda están en draws/, con las mismas columnas de identificación y una columna por simulación:
El manifiesto es un archivo YAML; se lee con el paquete yaml:
manifiesto <- yaml::read_yaml(file.path(corrida$dir, "manifest.yaml"))
names(manifiesto)
#>  [1] "schema"        "run_id"        "method"        "source"
#>  [5] "round"         "entities"      "generado"      "causa"
#>  [9] "params"        "inputs"        "files"         "cascada"
#> [13] "datos"         "decisiones"    "configuracion" "validacion"
#> [17] "limitaciones"
str(manifiesto$params[c("seed", "draws", "chains", "iter", "warmup", "engine", "lambda", "rho", "kappa")])
#> List of 9
#>  $ seed  : int 1
#>  $ draws : int 100
#>  $ chains: int 2
#>  $ iter  : int 2000
#>  $ warmup: int 1000
#>  $ engine: chr "mh"
#>  $ lambda: num 1
#>  $ rho   : num 0.5
#>  $ kappa : num 1
str(manifiesto$validacion$gates)
#> List of 3
#>  $ rhat_max: num 2.31
#>  $ ess_min : num 11.4
#>  $ force   : logi TRUE
manifiesto$limitaciones
#> [1] "AVD calibrado por edad al AVD del ancla — factor empírico avd/(prev*sum(pi*dw)) sin tope (composición etaria y comorbilidad, inseparables con proporciones de severidad iguales en todas las edades)"
#> [2] "pesos de discapacidad (DW) muestreados de forma independiente entre estados de salud"
#> [3] "mortalidad subnacional de validación de 2019 contra una cascada de 2023 — la validación de amplitud supone el gradiente subnacional estable entre ambos años — declarado en la configuración del proyecto"
#> [4] "cascada — X muestreado por simulación (el valor nacional una vez por simulación); supuesto ecológico y kappa declarados; renormalización de arriba hacia abajo (a diferencia de GBD)"
#> [5] "cascada — dX por banda de edad del proxy (interpolado linealmente entre los puntos medios de las bandas, desplazamiento sobre la malla; edades sin banda con el criterio cero en 30-39) — análogo subnacional de la covariable por edad de DisMod-MR"
validacion$gates dice el R-hat máximo y el tamaño efectivo mínimo de las cadenas y si la corrida se escribió saltando esa compuerta (force: true, como toda corrida de prueba). limitaciones enumera, con los hechos de esta corrida, lo que hay que tener presente al usar sus números. configuracion$por_defecto lista las claves de la configuración que tomaron su valor por defecto, y params$version_paquete, la versión del paquete que hizo la corrida (la que da dl_version()).
Nombres anteriores en los resultados
Algunos nombres de los resultados vienen de la versión 0.2.2, que se escribió para departamentos, y se conservan para que las corridas de las dos versiones se lean igual. Cuentan o describen las ubicaciones subnacionales, sean departamentos, regiones o provincias:
- en el manifiesto,
cascada$departamentos(el número de ubicaciones de la estimación subnacional) y, envalidacion$amplitud_csmr,n_departamentos(las ubicaciones con datos reservados para validar); - la columna
n_departamentosde la validación de amplitud dedl_validar_ancla(); - las columnas
dpto_min,dpto_medydpto_maxy el atributodepartamentaldedl_sensibilidad().
Y «csmr», en esos nombres y en algunos textos del manifiesto, es la mortalidad por la causa.
Versiones de una corrida
El nombre de una corrida (run_id) es AAAA-MM-DD_<nombre>_v<n>: la fecha, un nombre corto y una versión. dl_correr() la llama causa-<causa>, con -prueba al final si es una corrida de prueba. Correr de nuevo el mismo día no borra nada: la corrida nueva es la versión siguiente (_v2, _v3…). Así nunca se pierde una corrida y siempre queda claro cuál es la más reciente.
Volver a resumir una corrida
dl_reresumir_corrida() recalcula las estimaciones (val, lower, upper) desde las simulaciones guardadas en draws/, sin volver a ajustar, y escribe una corrida nueva con la versión siguiente. El resto de la carpeta (simulaciones, insumos, diagnósticos, etiquetas) se enlaza desde la corrida original, que no se toca. Sirve para poner al día corridas hechas con una versión anterior del paquete: las de versiones anteriores a la 0.2.2 usaban la mediana como valor central, y el re-resumen las lleva a la media y lo declara en las limitaciones.
Para validar las celdas nuevas necesita las rutas del proyecto (los catálogos de ubicaciones y edades):
reresumen <- dl_reresumir_corrida(corrida$dir, carpeta = file.path(proyecto, "resultados"),
                                  rutas = dl_proyecto(proyecto, causa = 9100)$rutas)
reresumen
#> <dl_run> corrida 2026-10-15_causa-9100-prueba_v2 (re-resumen de 2026-10-15_causa-9100-prueba_v1)
#>   carpeta: /tmp/RtmpMPrJGj/mi_proyecto/resultados/mod/dismod_lite/2026-10-15_causa-9100-prueba_v2
#>   3 particiones canónicas (una por medida) | exportada con forzar = TRUE
str(reresumen$manifest$resumen)
#> List of 2
#>  $ run_origen          : chr "2026-10-15_causa-9100-prueba_v1"
#>  $ estadistico_anterior: chr "media"
Con el mismo valor central, las estimaciones re-resumidas son las mismas:
La corrida tiene que haber guardado sus simulaciones (dl_correr() siempre las guarda; en dl_exportar_corrida(), guardar_simulaciones = TRUE, el valor por defecto).
Otro año y varios años
El año que se estima es anio en la configuración, y para estimar otros no hace falta editarla. dl_correr() con anios corre la causa una vez por año, en orden, y vuelve a leer el proyecto para cada uno. El ejemplo trae 2019 y 2023:
corridas <- dl_correr(proyecto, causa = 9100, semilla = 1, rapido = TRUE, sensibilidad = FALSE,
                      anios = c(2019, 2023))
corridas
#> <dl_corridas> 2 corrida(s), una por año
#>   2019: 2026-10-15_causa-9100-2019-prueba_v1
#>   2023: 2026-10-15_causa-9100-2023-prueba_v1
corridas[["2019"]]$manifest$params$year
#> [1] 2019
Devuelve una corrida por año, con los años como nombres, y el nombre de cada corrida lleva el año (causa-<causa>-<año>). Cada una es una corrida completa, como la de un dl_correr() sin anios. Antes de correr el primer año, dl_correr() lee el proyecto para todos: si el de alguno no se puede leer (por ejemplo, falta su población), se detiene ahí, con el año y el problema, sin haber escrito ninguna corrida. Si un año falla al correr, se detiene con el error de ese año y dice qué años quedaron escritos, que siguen en su carpeta.
El proyecto necesita las filas de cada año en las descargas del ancla (ancla/), en poblacion.csv y, para la estimación subnacional con covariables, en la tabla covariables (los valores nacionales del GHDx y los valores subnacionales, que con proxies_crudos se calibran para cada año); dl_revisar_proyecto() dice qué falta.
Para leer el proyecto de otro año sin correrlo (mirar sus insumos, ir paso a paso), dl_proyecto() tiene el argumento anio, que vale como escribir ese año en la configuración:
dl_proyecto(proyecto, causa = 9100, anio = 2019)$configuracion$years$ajuste
#> [1] 2019
Proyectar un año sin estimación de referencia
Cuando el año que se quiere estimar todavía no tiene estimación de referencia publicada, el nivel nacional se proyecta desde la del año anterior. No hay que declararlo: si la tabla ancla no trae la prevalencia de la causa en el año que se estima y sí la del año anterior, el año del ancla es ese, y un mensaje lo anuncia. El ejemplo trae la población de 2024 y el ancla hasta 2023:
proyecto_2024 <- dl_proyecto(proyecto, causa = 9100, anio = 2024)
#> dl_proyecto(): el ancla no trae 2024: se proyecta desde 2023, el último año anterior con la prevalencia de la causa 9100 (el nivel nacional es el de 2023; para otro año, declara ancla: {anio: ...})
corrida_2024 <- dl_correr(proyecto_2024, semilla = 1, rapido = TRUE, sensibilidad = FALSE)
#> dl_correr(): corrida de prueba (rapido = TRUE): 2 cadena(s) de 2000 iteraciones y forzar = TRUE, que la escribe aunque las cadenas no converjan. Sus números no sirven para publicar: para la corrida final, rapido = FALSE
#> dl_correr(): causa 9100: insumos
#> dl_correr(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
#> dl_correr(): ajuste nacional: 2 cadena(s) de 2000 iteraciones por sexo (motor mh)
#> dl_correr(): cascada subnacional
#> dl_correr(): validación contra el ancla y AVD
#> dl_correr(): etiquetas de cuánto informan los datos
#> dl_correr(): corrida escrita en /tmp/RtmpMPrJGj/mi_proyecto/resultados/mod/dismod_lite/2026-10-15_causa-9100-prueba_v3 (prueba: no sirve para publicar)
str(corrida_2024$manifest$params[c("year", "anio_ancla")])
#> List of 2
#>  $ year      : int 2024
#>  $ anio_ancla: int 2023
grep("proyecci", unlist(corrida_2024$manifest$limitaciones), value = TRUE)
#> [1] "proyección automática — ancla (prevalencia, csmr, covariables) de 2023 reetiquetada a 2024 — el nivel nacional y su incertidumbre son los de 2023; del 2024 son solo la población (poblacion) y los proxies subnacionales de la cascada — la tabla ancla no trae la prevalencia de la causa en 2024; se proyecta desde 2023, el último año anterior que trae"
La regla del año del ancla es una sola, venga el año de la configuración, de dl_proyecto(anio = ) o de dl_correr(anios = ):
Sin
ancla.anio: el año que se estima, si el ancla lo trae; si no, el último año anterior que trae, a lo sumo un año antes (la proyección mantiene el nivel nacional, no lo extrapola: con el ancla hasta 2023 se puede estimar 2024, no 2025). La proyección se anuncia con un mensaje,dl_revisar_proyecto()la muestra como aviso y queda en el manifiesto de la corrida, en la procedencia del año del ancla y entre las limitaciones.-
Con
ancla.anio: ese año, declarado de forma explícita (y sin anuncio), que no puede ser posterior aanio:anio: 2024 ancla: anio: 2023 # la estimación de referencia más recienteCon
anioso condl_proyecto(anio = ), el año del ancla es el menor entreancla.anioy el año que se estima: esa misma configuración sirve para 2024 (proyectado desde 2023) y para 2023 y los años anteriores, cada uno con su propia ancla. Si el ancla no trae el año que se estima ni el anterior,
dl_proyecto()se detiene y dice qué años trae.
Una proyección tiene un alcance preciso, y el manifiesto lo declara: el nivel nacional y su incertidumbre son los del año del ancla, con el año nuevo en las tablas; del año nuevo son solo la población (que cambia los conteos y los pesos por edad) y, con la estimación subnacional por covariables, sus valores subnacionales en la tabla covariables. Para esto el proyecto necesita la población y los proxies del año nuevo, y las covariables nacionales del año del ancla (el promedio de los proxies, ponderado por la población, debe cerrar en ese valor nacional; ver Preparar tus datos).
Las corridas de la causa 9100 quedan así, una carpeta por corrida:
list.files(file.path(proyecto, "resultados", "mod", "dismod_lite"))
#> [1] "2026-10-15_causa-9100-2019-prueba_v1"
#> [2] "2026-10-15_causa-9100-2023-prueba_v1"
#> [3] "2026-10-15_causa-9100-prueba_v1"
#> [4] "2026-10-15_causa-9100-prueba_v2"
#> [5] "2026-10-15_causa-9100-prueba_v3"
El nombre solo dice el año en las corridas de anios; el año de toda corrida está en su manifiesto (params$year). Por eso las corridas de años distintos no compiten entre sí cuando se consolidan (abajo): se elige la más reciente de cada causa y año.
Todas las causas de un proyecto
dl_correr() corre una causa. Para correr todas las de un proyecto basta un bucle sobre sus configuraciones (config/<causa>.yaml), con las causas que se ajustan primero y las que son la suma de sus subtipos (suma_de_subtipos: sí) al final; aquí, de prueba:
archivos <- list.files(file.path(proyecto, "config"), full.names = TRUE)
causas <- as.integer(sub("[.]yaml$", "", basename(archivos)))
es_suma <- vapply(archivos, function(archivo) {
  suma <- yaml::read_yaml(archivo)$suma_de_subtipos        # «sí» se lee como texto; «no», como FALSE
  !is.null(suma) && !isFALSE(suma)
}, NA)
causas <- causas[order(es_suma)]                           # las sumas, al final
todas <- lapply(causas, function(causa)
  dl_correr(proyecto, causa = causa, semilla = 1, rapido = TRUE, sensibilidad = FALSE))
vapply(todas, function(corrida) corrida$run_id, "")
#> [1] "2026-10-15_causa-9100-prueba_v4" "2026-10-15_causa-9101-prueba_v1"
#> [3] "2026-10-15_causa-9102-prueba_v1" "2026-10-15_causa-9103-prueba_v1"
El orden importa: dl_correr() de una suma toma las corridas de sus subtipos que encuentra ya escritas. Si la suma corriera antes (en config/ las causas salen por su número, y el de la causa padre puede ser menor que el de sus subtipos), la primera vez fallaría porque faltan esas corridas y, en una segunda pasada, sumaría en silencio las anteriores, que se vuelven a correr después. Con anios en esa llamada, cada causa se corre para todos los años (ver Subtipos y suma).
El registro de corridas y las tablas consolidadas
Cuando un proyecto cubre varias causas y años, las tablas consolidadas reúnen la corrida vigente de cada causa y año en una tabla por medida, con tasas y conteos (tasa × población de la corrida) y con las columnas que declara un perfil de columnas. Además del registro de corridas, usa el registro de causas del proyecto: los nombres de las causas en español y cuáles son la suma de sus subtipos (master_gbd.csv) y las etiquetas en español de medidas, métricas y edades (etiquetas_es.csv). dl_proyecto() los arma con la configuración y las tablas, en la carpeta registry de sus rutas.
El registro de corridas
El registro es un archivo YAML con la lista datasets; uno vacío tiene una sola línea, datasets: []. Cada corrida que se escribe con un registro agrega una entrada al final, sin reescribir las anteriores. dl_correr() la anota con su argumento registro (y dl_exportar_corrida(), si la corrida se arma paso a paso). Aquí, una corrida de prueba del subtipo 9101 del proyecto de ejemplo:
raiz <- file.path(tempdir(), "corridas")
dir.create(raiz)
registro <- file.path(raiz, "registro_corridas.yaml")
writeLines("datasets: []", registro)
corrida_9101 <- dl_correr(dl_ejemplo(), causa = 9101, semilla = 1, rapido = TRUE, sensibilidad = FALSE,
                          carpeta_salida = raiz, registro = registro)
#> dl_correr(): corrida de prueba (rapido = TRUE): 2 cadena(s) de 2000 iteraciones y forzar = TRUE, que la escribe aunque las cadenas no converjan. Sus números no sirven para publicar: para la corrida final, rapido = FALSE
#> dl_correr(): causa 9101: insumos
#> dl_correr(): ajuste nacional: 2 cadena(s) de 2000 iteraciones por sexo (motor mh)
#> dl_correr(): cascada subnacional
#> dl_correr(): validación contra el ancla y AVD
#> dl_correr(): se omite la validación con la mortalidad subnacional reservada: los datos no la traen
#> dl_correr(): etiquetas de cuánto informan los datos
#> dl_correr(): corrida escrita en /tmp/RtmpMPrJGj/corridas/mod/dismod_lite/2026-10-15_causa-9101-prueba_v1 (prueba: no sirve para publicar)
cat(head(readLines(registro), 9), sep = "\n")
#> datasets:
#>   - run_id: 2026-10-15_causa-9101-prueba_v1
#>     method: dismod_lite
#>     source: gbd
#>     round: '2023'
#>     generado: '2026-10-15'
#>     status: active
#>     partitions:
#>       - path: mod/dismod_lite/2026-10-15_causa-9101-prueba_v1/cause/prevalence/2026-10-15_causa-9101-prueba_v1.csv
La entrada del registro dice qué es la corrida y qué archivos escribió, con su sha256 y su número de filas. También anotan en el registro dl_reresumir_corrida() y dl_sumar_hijas(), con su argumento registro, y dl_consolidar(), con registro_salida.
La corrida vigente de cada causa y año
dl_consolidado_seleccionar() lee el registro y elige, por causa y año, la corrida activa más reciente (por la fecha y la versión de su run_id); las demás siguen en el registro, pero no se eligen:
proyecto_9101 <- dl_proyecto(dl_ejemplo(), causa = 9101)
seleccion <- dl_consolidado_seleccionar(registro, carpeta_corridas = raiz, rutas = proyecto_9101$rutas)
as.data.frame(seleccion)[, c("cause_id", "year", "run_id")]
#>   cause_id year                          run_id
#> 1     9101 2023 2026-10-15_causa-9101-prueba_v1
Una causa que master_gbd.csv declara como la suma de sus subtipos (en el ejemplo, la 9100) debe venir de dl_sumar_hijas(), no de un ajuste directo; ver Subtipos y suma.
Una causa con subtipos desde su propio ajuste
La excepción a esa regla se declara al consolidar. Si una causa con subtipos se modeló entera, con un ajuste propio (por ejemplo, porque su estimación de referencia ya es la suma de los subtipos que se reportan y los demás no se modelan), se nombra en ajuste_directo y su corrida vigente se toma tal cual:
seleccion <- dl_consolidado_seleccionar(registro, carpeta_corridas = raiz, rutas = rutas, ajuste_directo = 9100)
consolidado <- dl_consolidar(registro, carpeta = raiz, perfil = perfil, maestro = maestro, rutas = rutas,
                             ajuste_directo = 9100)
El bloque de esa causa en el manifiesto del consolidado lleva ajuste_directo: true y las limitaciones dicen que no es la suma de sus subtipos. El argumento se revisa: nombrar una causa que no está entre las que se consolidan, o cuya corrida vigente es una suma, es un error; nombrar una que el maestro no declara con subtipos da un aviso y no cambia nada. Si los subtipos de esa causa también están en el consolidado, sus filas no tienen por qué sumar las de la causa: cada una sale de su propio ajuste, y solo la suma (dl_sumar_hijas()) garantiza que las tablas sumen.
El consolidado y el perfil de columnas
dl_consolidar() arma la tabla canónica (las estimaciones de cada corrida elegida, en tasas, más sus conteos), la valida y la escribe en <carpeta>/mod/consolidado/<run_id>/, con una tabla por medida con la forma del perfil. Encadena tres piezas que también se pueden llamar por separado: dl_consolidado_canonico() apila las celdas de las corridas elegidas, dl_consolidado_conteos() agrega los conteos (tasa × población de la corrida) y dl_perfil_proyectar() lleva la tabla canónica a la forma de un perfil.
consolidado <- dl_consolidar(registro, carpeta = raiz,
                             perfil = system.file("perfiles", "perfil_v2.yaml", package = "dismodlite"),
                             maestro = file.path(proyecto_9101$rutas$registry, "master_gbd.csv"),
                             rutas = proyecto_9101$rutas, causas = 9101, anios = 2023)
consolidado
#> <dl_run> corrida 2026-10-15_consolidado_v1 (consolidado)
#>   carpeta: /tmp/RtmpMPrJGj/corridas/mod/consolidado/2026-10-15_consolidado_v1
#>   3 particiones canónicas (una por medida)
list.files(consolidado$dir, recursive = TRUE)
#> [1] "canonico/cause/incidence/2026-10-15_consolidado_v1.csv"
#> [2] "canonico/cause/prevalence/2026-10-15_consolidado_v1.csv"
#> [3] "canonico/cause/yld/2026-10-15_consolidado_v1.csv"
#> [4] "manifest.yaml"
#> [5] "tablas/avd.csv"
#> [6] "tablas/incidencia.csv"
#> [7] "tablas/prevalencia.csv"-
canonico/: la tabla canónica por medida, con las columnas de las corridas yrun_fuente(la corrida de donde sale cada fila). -
tablas/: una tabla por medida con las columnas del perfil. -
manifest.yaml: el perfil usado (con su sha256), las corridas de cada causa y año, los huecos (causa y año sin corrida, si se permiten conpermitir_huecos = TRUE) y las limitaciones.
tabla <- read.csv(file.path(consolidado$dir, "tablas", "prevalencia.csv"), colClasses = c(ubigeo = "character"))
table(tabla$metrica)
#>
#>     Número Proporción
#>        624        624
head(tabla[tabla$metrica == "Número", c("ubigeo", "departamento", "edad", "sexo_id", "valor", "inferior",
                                          "superior")], 3)
#>   ubigeo departamento         edad sexo_id    valor  inferior superior
#> 1     01     Amazonas 40 a 44 años       1 114.0774  79.50849 146.1402
#> 2     01     Amazonas 45 a 49 años       1 142.8750 108.39401 170.8289
#> 3     01     Amazonas 50 a 54 años       1 165.2743 126.06181 198.8368
El perfil es un archivo YAML corto que dice qué medidas y métricas se escriben, cómo se llama cada archivo y, para cada columna de salida, de qué columna de la tabla canónica sale y con qué formato. El paquete trae dos: perfil_v1.yaml (columnas en español; nombres de medida, métrica y edad del catálogo) y perfil_v2.yaml (todo en español). Este es el segundo:
cat(readLines(system.file("perfiles", "perfil_v2.yaml", package = "dismodlite"), encoding = "UTF-8"),
    sep = "\n")
#> # Perfil de columnas de dl_consolidar(): declara la forma de las tablas de tablas/ (una por medida).
#> #   perfil     identificador del perfil (queda en el manifiesto del consolidado)
#> #   archivos   una tabla por medida; {measure_slug_es} es el nombre de la medida en español (prevalencia,
#> #              incidencia, avd), tomado de etiquetas_es.csv del registro
#> #   medidas    medidas que se escriben
#> #   metrics    métricas: 1 = número de casos, 2 = porcentaje (proporción), 3 = tasa por 100 000
#> #   columnas   columna de salida, columna de origen en la tabla canónica y formato opcional (texto o decimales);
#> #              las columnas *_name_es salen de etiquetas_es.csv del registro
#> perfil: perfil_v2
#> descripcion: >-
#>   una tabla larga por medida, todo en español (archivos prevalencia, incidencia y avd; medida, métrica
#>   y edad); tasas y conteos
#> archivos: {por: measure, nombre: "{measure_slug_es}.csv"}
#> medidas: [prevalence, incidence, yld]
#> metrics: [2, 3, 1]
#> columnas:
#>   - {salida: causa_gbd_id, origen: cause_id}
#>   - {salida: causa_gbd,    origen: cause_name_es}
#>   - {salida: anio,         origen: year}
#>   - {salida: ubigeo,       origen: location_id, formato: texto}
#>   - {salida: departamento, origen: location_name}
#>   - {salida: nivel,        origen: location_level}
#>   - {salida: edad_id,      origen: age_group_id}
#>   - {salida: edad,         origen: age_group_name_es}
#>   - {salida: sexo_id,      origen: sex_id}
#>   - {salida: medida,       origen: measure_name_es}
#>   - {salida: metrica,      origen: metric_name_es}
#>   - {salida: valor,        origen: val,   formato: {decimales: 8}}
#>   - {salida: inferior,     origen: lower, formato: {decimales: 8}}
#>   - {salida: superior,     origen: upper, formato: {decimales: 8}}
#>   - {salida: run_origen,   origen: run_fuente}
Los perfiles incluidos llaman ubigeo y departamento a las columnas de la ubicación, como en el ejemplo. Para otra forma de tabla (otros nombres de columna, otras métricas), copia uno de los dos, cámbiale el identificador (perfil) y las columnas, y pásalo a dl_consolidar(); dl_perfil_cargar() lo valida. Las métricas son 1 (número de casos), 2 (porcentaje, como proporción) y 3 (tasa por 100 000). Los conteos se calculan con la población congelada en los insumos de cada corrida.
Una causa sin incidencia en el consolidado
En algunas causas el modelo no identifica la incidencia: sin datos de incidencia ni de mortalidad, la fija la remisión que se declara, y reportarla sería reportar ese supuesto. La configuración de la causa lo dice así, con el motivo en notas:
exportar:
  incidencia: no

notas:
  - "incidencia fuera de las tablas consolidadas: la fija la remisión declarada, sin datos de incidencia"
La corrida no cambia: escribe la incidencia como siempre (cause/incidence/ y draws/), porque la usan el diagnóstico y las sumas. Cambian dos cosas. Su manifiesto lleva causa.exporta_incidencia: false y una limitación que lo dice. Y dl_consolidar() toma de esa corrida la prevalencia y los AVD, no la incidencia: la tabla de incidencia del consolidado trae solo las demás causas, el bloque de la causa en su manifiesto lleva incidencia_exportada: false y sus limitaciones la nombran. dl_revisar_proyecto() lo muestra en la línea de la configuración. Una causa que es la suma de sus subtipos no hereda la marca: suma la incidencia de todos, también la de un subtipo que la deja fuera, y su incidencia sí llega al consolidado. Así, un consolidado puede traer la incidencia de la causa padre y no la de uno de sus subtipos.
Siguientes pasos
- Diagnóstico y sensibilidad: cómo leer los diagnósticos de una corrida, las dos compuertas, la sensibilidad y cuánto tarda una corrida de producción.
- Subtipos y suma: varias causas en un proyecto y la suma de sus subtipos.
- La ayuda de cada función:
?dl_correr,?dl_exportar_corrida,?dl_reresumir_corrida,?dl_consolidar.