
library(dismodlite)
library(data.table)
#>
#> Attaching package: 'data.table'
#> The following object is masked from 'package:base':
#>
#> %notin%Qué vas a aprender
- Qué hace el paquete con los datos de la tabla
datospor defecto. - Cómo hacer que entren al ajuste nacional (
datos_en_ajuste) y qué filas entran. - Por qué los datos que ya informaron la estimación de referencia pueden contarse dos veces, y cómo evitarlo con
ancla.peso. - Cómo entra cada dato a la verosimilitud: con
valoryerror_estandar, o concasosymuestra. - Cómo excluir un dato atípico (
excluirymotivo).
El ejemplo es el proyecto sintético del paquete (la arteriopatía crónica sintética, causa 9100, en el Perú y sus departamentos). Todo vale igual para cualquier país.
Los datos locales de un proyecto
Los datos locales van en la tabla datos (datos.csv), una fila por dato: su medida (prevalencia, incidencia, mortalidad o prevalencia_registro), su ubicación, sexo, edades y año, y su valor con su error estándar o sus casos y su muestra. La prevalencia va como proporción y las tasas, por persona-año (no por 100 000). La guía Preparar tus datos describe cada columna y sus unidades, y muestra cómo la revisión detecta una mortalidad escrita por 100 000.
El ejemplo trae datos nacionales de 2023 (mortalidad de un registro vital, un estudio de prevalencia con casos y muestra, una cohorte de incidencia con valor y error estándar, y un valor atípico ya excluido) y datos subnacionales de 2019 (mortalidad y prevalencia):
datos <- fread(dl_ejemplo("datos.csv"), colClasses = list(character = "ubicacion"), encoding = "UTF-8")
datos[, .(filas = .N, excluidas = sum(excluir)), by = .(medida, nacional = ubicacion == "123", anio)]
#>         medida nacional  anio filas excluidas
#>         <char>   <lgcl> <int> <int>     <int>
#> 1:  mortalidad     TRUE  2023    14         0
#> 2: prevalencia     TRUE  2023     7         1
#> 3:  incidencia     TRUE  2023     4         0
#> 4: prevalencia    FALSE  2019    40         0
#> 5:  mortalidad    FALSE  2019   120         0
datos[ubicacion == "123" & medida != "mortalidad",
      .(medida, sexo, edad_inicio, edad_fin, valor, error_estandar, casos, muestra, excluir)]
#>          medida    sexo edad_inicio edad_fin       valor error_estandar casos
#>          <char>  <char>       <int>    <int>       <num>          <num> <int>
#>  1: prevalencia hombres          60       65          NA             NA    32
#>  2: prevalencia hombres          70       75          NA             NA    49
#>  3: prevalencia hombres          80      125          NA             NA    70
#>  4: prevalencia mujeres          60       65          NA             NA    25
#>  5: prevalencia mujeres          70       75          NA             NA    46
#>  6: prevalencia mujeres          80      125          NA             NA    83
#>  7:  incidencia hombres          60       70 0.004588399   0.0009176799    NA
#>  8:  incidencia hombres          70       80 0.005295019   0.0010590038    NA
#>  9:  incidencia mujeres          60       70 0.002811165   0.0005622330    NA
#> 10:  incidencia mujeres          70       80 0.004907128   0.0009814256    NA
#> 11: prevalencia mujeres          65       70 0.135691395   0.0271382791    NA
#>     muestra excluir
#>       <int>  <lgcl>
#>  1:     800   FALSE
#>  2:     800   FALSE
#>  3:     800   FALSE
#>  4:     800   FALSE
#>  5:     800   FALSE
#>  6:     800   FALSE
#>  7:      NA   FALSE
#>  8:      NA   FALSE
#>  9:      NA   FALSE
#> 10:      NA   FALSE
#> 11:      NA    TRUE
Por defecto, los datos no entran al ajuste
Con la configuración del ejemplo, que no declara datos_en_ajuste, el ajuste usa solo el ancla. Las filas nacionales se leen y se dejan fuera (un mensaje lo dice); las subnacionales del año subnacional.anio_validacion se reservan para validar la estimación subnacional (ver la guía Estimación subnacional).
opciones <- dl_opciones_mcmc(simulaciones = 200, cadenas = 2, iteraciones = 8000, calentamiento = 4000,
                             nucleos = 4)
insumos_ancla <- dl_insumos(dl_proyecto(dl_ejemplo(), causa = 9100))
#> dl_insumos(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
ajuste_ancla <- dl_ajustar(insumos_ancla, opciones, semilla = 1)
Las cadenas son cortas para que la guía corra en segundos (y nucleos = 4 las corre en paralelo, con el mismo resultado); una estimación para publicar usa las de producción (los valores por defecto de dl_opciones_mcmc()).
Es el valor por defecto por una razón: la estimación de referencia de GBD ya usó muchas de las fuentes nacionales de un país. Meterlas otra vez al ajuste las cuenta dos veces y da intervalos demasiado estrechos. Los datos entran solo cuando el modelador lo decide, y entonces conviene bajar el peso del ancla.
Hacer que entren: datos_en_ajuste
datos_en_ajuste lista las medidas cuyas filas nacionales entran al ajuste. Para probarlo, una copia del proyecto de ejemplo en una carpeta temporal (en un proyecto propio basta con editar su configuración):
con_datos <- dl_ejemplo(copiar_en = file.path(tempdir(), "con_datos"))Su configuración, config/9100.yaml, con las tres medidas en el ajuste:
causa: 9100
anio: 2023
edad_inicio: 30

mortalidad_exceso:
  techo: 0.25

datos_en_ajuste: [prevalencia, incidencia, mortalidad]

subnacional:
  anio_validacion: 2019
insumos_peso1 <- dl_insumos(dl_proyecto(con_datos, causa = 9100))
#> Warning: dl_insumos(): la causa 9100 usa datos locales en el ajuste
#> (datos_en_ajuste) con ancla.peso = 1: la estimación de referencia puede incluir
#> ya esos datos y contarlos dos veces. Considera ancla.peso: 0.5 y anota el
#> motivo en `notas`
insumos_peso1$datos[, .N, by = .(tipo_dato, nacional = location_level == 0L, excluido = outlier)]
#>       tipo_dato nacional excluido     N
#>          <char>   <lgcl>   <lgcl> <int>
#> 1:         csmr     TRUE    FALSE    14
#> 2: prev_estudio     TRUE    FALSE     6
#> 3:   incidencia     TRUE    FALSE     4
#> 4: prev_estudio     TRUE     TRUE     1
#> 5: prev_estudio    FALSE    FALSE    40
#> 6:         csmr    FALSE    FALSE   120
Qué filas entran:
- Las filas nacionales del año que se estima: su año, o su rango de
anio_inicioaanio_fin, debe incluiranio. Entran si su medida está endatos_en_ajustey no están excluidas. - Las filas subnacionales nunca entran; las del año
subnacional.anio_validacionvalidan la estimación subnacional. - Las filas de otros años y las de ambos sexos se dejan fuera, con un mensaje que las cuenta. Las subnacionales de 2019 del ejemplo se reservan para validar solo porque la configuración declara
subnacional.anio_validacion: 2019; sin esa clave, el año de validación es el que se estima y quedarían fuera. Una encuesta nacional de otro año tampoco entra: revisa que los años de tus datos incluyananio. Si ninguna fila nacional queda en el ajuste, otro mensaje lo dice. - Toda fila nacional de ese año que no esté excluida debe ser de una medida de
datos_en_ajuste. Eso vale también paraprevalencia_registro, que no entra nunca al ajuste y no se puede poner endatos_en_ajuste: con datos en el ajuste, sus filas nacionales se marcan conexcluir: TRUEy su motivo.
Si solo se quiere el estudio de prevalencia, las demás filas nacionales se excluyen con su motivo, o dl_insumos() se detiene y lo explica:
solo_prevalencia <- dl_ejemplo(copiar_en = file.path(tempdir(), "solo_prevalencia"))causa: 9100
anio: 2023
edad_inicio: 30
ancla:
peso: 0.5
datos_en_ajuste: [prevalencia]
subnacional:
anio_validacion: 2019
dl_insumos(dl_proyecto(solo_prevalencia, causa = 9100))
#> Error:
#> ! dl_insumos(): la tabla datos tiene 1 problema(s):
#>   - datos: tipo(s) de dato mortalidad, incidencia en filas nacionales que entran al ajuste sin estar en datos_en_ajuste de la configuración: agrégalo(s) a datos_en_ajuste o marca esas filas para excluir, con su motivo
El doble conteo y ancla.peso
Arriba, dl_insumos() avisó: con datos en el ajuste y el ancla a peso completo, la estimación de referencia puede incluir ya esos datos. El ancla entra al ajuste como un power prior: su término de la log-posterior se multiplica por λ = ancla.peso. Con λ = 1 el ancla pesa con su propia incertidumbre; con λ = 0.5 pesa como si su varianza fuera el doble, y los datos locales tienen más voz. Con la tabla fuentes_gbd (las fuentes que GBD ya usó; ver Preparar tus datos) el aviso pasa a ser una regla: si trae fuentes no fatales del país, con ancla.peso 1 y alguna medida en datos_en_ajuste, dl_insumos() se detiene y pide bajar el peso. Sin datos en el ajuste (datos_en_ajuste vacío) no hay doble conteo: el ancla va a peso completo aunque la tabla traiga fuentes locales; dl_insumos() lo dice con un mensaje, que dl_revisar_proyecto() muestra como aviso, y la corrida registra las fuentes en su manifiesto (params.fuentes_locales_no_fatales) y lo declara entre sus limitaciones. La elección se anota en notas, que queda en el manifiesto de cada corrida:
peso05 <- dl_ejemplo(copiar_en = file.path(tempdir(), "peso05"))causa: 9100
anio: 2023
edad_inicio: 30
ancla:
peso: 0.5
mortalidad_exceso:
techo: 0.25
datos_en_ajuste: [prevalencia, incidencia, mortalidad]
subnacional:
anio_validacion: 2019
notas:
- "ancla.peso 0.5: el registro vital y el estudio de prevalencia ya informaron la estimación de referencia"
insumos_peso05 <- dl_insumos(dl_proyecto(peso05, causa = 9100))
ajuste_peso1 <- dl_ajustar(insumos_peso1, opciones, semilla = 1)
ajuste_peso05 <- dl_ajustar(insumos_peso05, opciones, semilla = 1)
La prevalencia de las mujeres con las tres configuraciones, frente al ancla, al estudio de prevalencia y a la curva verdadera con la que se generaron los datos sintéticos:
prevalencia <- function(ajuste) dl_estimaciones(ajuste)[location_id == "123" & sex_id == 2 & edad >= 40]
ancla <- insumos_ancla$prior_gbd[measure_id == 5 & sex_id == 2]
estudio <- datos[ubicacion == "123" & medida == "prevalencia" & sexo == "mujeres" & !excluir]
estudio[, p := casos / muestra]
verdad <- fread(dl_ejemplo("verdad.csv"), colClasses = list(character = "location_id"))[
  cause_id == 9100 & location_id == "123" & anio == 2023 & sex_id == 2 & edad >= 40]

curvas <- list(prevalencia(ajuste_ancla), prevalencia(ajuste_peso1), prevalencia(ajuste_peso05))
colores <- c("grey45", "#e6550d", "#08519c")
plot(verdad$edad, 100 * verdad$p, type = "n", ylim = c(0, 25), xlab = "Edad (años)", ylab = "Prevalencia (%)",
     main = "Mujeres: el ancla, los datos y su peso", sub = "Datos sintéticos")
polygon(c(curvas[[3]]$edad, rev(curvas[[3]]$edad)), 100 * c(curvas[[3]]$inferior, rev(curvas[[3]]$superior)),
        col = "#9ecae160", border = NA)
lines(verdad$edad, 100 * verdad$p, lty = 2, lwd = 2, col = "#cb181d")
segments(ancla$age_start, 100 * ancla$val, pmin(ancla$age_end, 99), 100 * ancla$val, col = "grey20", lwd = 3)
for (k in 1:3) lines(curvas[[k]]$edad, 100 * curvas[[k]]$media, col = colores[k], lwd = 2)
segments(estudio$edad_inicio, 100 * estudio$p, pmin(estudio$edad_fin, 99), 100 * estudio$p, col = "#31a354",
         lwd = 3)
legend("topleft", c("verdad", "ancla (por grupo de edad)", "estudio de prevalencia", "solo el ancla",
                    "con datos, ancla.peso 1", "con datos, ancla.peso 0.5 (e IC 95 %)"),
       col = c("#cb181d", "grey20", "#31a354", colores), lty = c(2, 1, 1, 1, 1, 1), lwd = c(2, 3, 3, 2, 2, 2),
       bty = "n", cex = 0.8)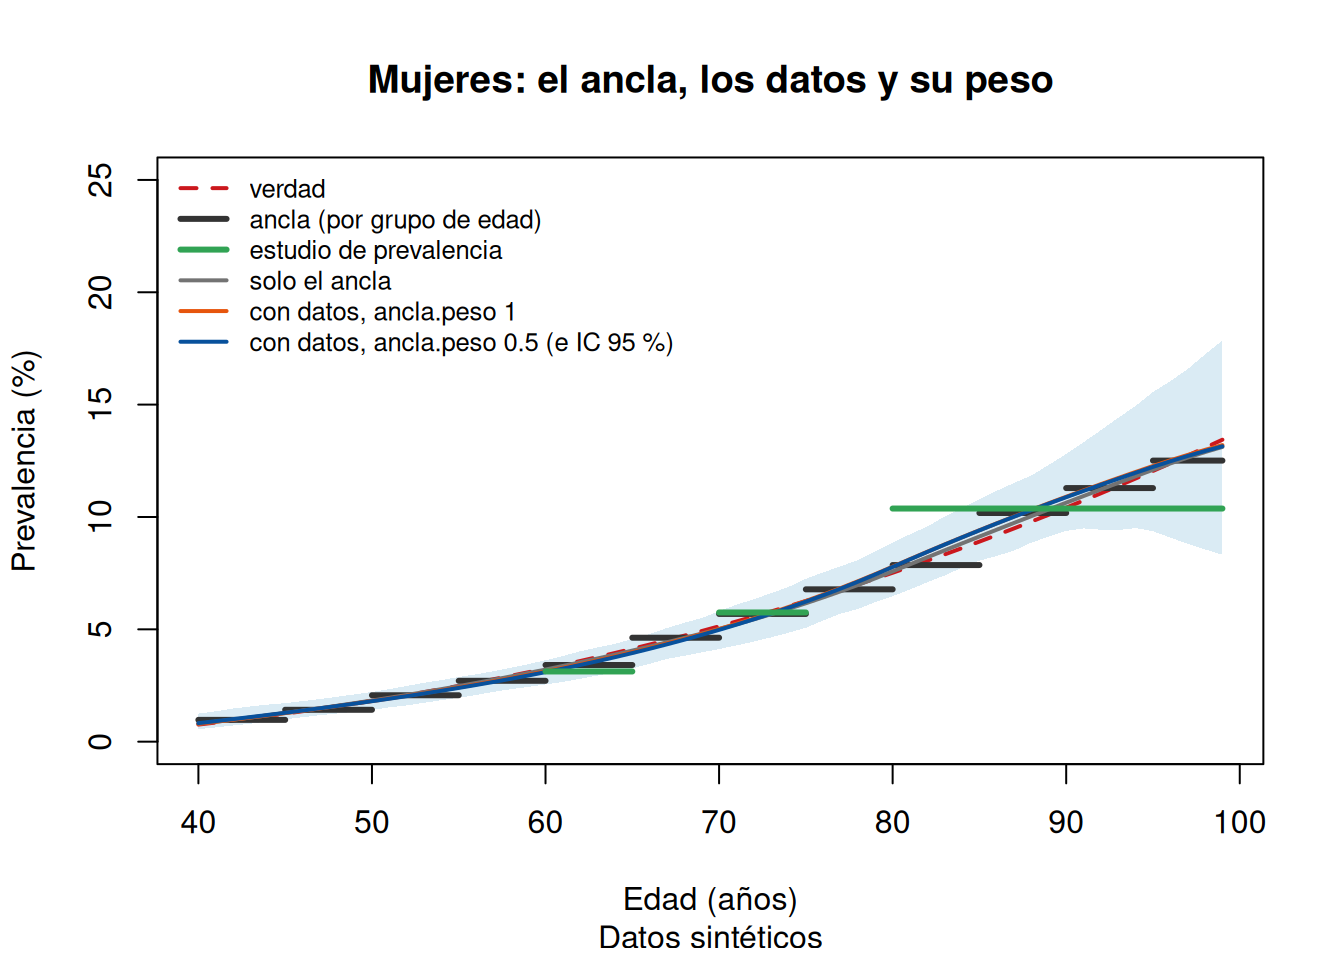
La media y el ancho del intervalo del 95 % en algunas edades:
resumen <- function(ajuste, nombre) prevalencia(ajuste)[edad %in% c(60, 70, 80, 90),
  .(ajuste = nombre, edad, media = round(100 * media, 2), ancho_ic = round(100 * (superior - inferior), 2))]
tabla_peso <- dcast(rbind(resumen(ajuste_ancla, "solo ancla"), resumen(ajuste_peso1, "peso 1"),
                          resumen(ajuste_peso05, "peso 0.5")),
                    edad ~ ajuste, value.var = c("media", "ancho_ic"))
tabla_peso
#> Key: <edad>
#>     edad media_peso 0.5 media_peso 1 media_solo ancla ancho_ic_peso 0.5
#>    <int>          <num>        <num>            <num>             <num>
#> 1:    60           3.10         3.13             3.21              1.08
#> 2:    70           4.98         5.01             5.02              1.69
#> 3:    80           7.78         7.79             7.58              2.38
#> 4:    90          10.88        10.90            10.64              3.42
#>    ancho_ic_peso 1 ancho_ic_solo ancla
#>              <num>               <num>
#> 1:            0.92                1.14
#> 2:            1.50                2.21
#> 3:            2.22                3.69
#> 4:            2.63                4.39
Con datos en el ajuste, el intervalo mide entre el 60 % y el 95 % del ancho que tiene con solo el ancla, según la edad y λ: los datos aportan información que el ancla sola no tiene. Las medias se mueven poco porque en este ejemplo el ancla y los datos son observaciones con ruido de la misma curva verdadera y cuentan casi la misma historia; el cambio mayor está después de los 80 años, donde el estudio de prevalencia queda por encima del ancla. Con λ = 0.5 el intervalo queda algo más ancho que con λ = 1: la información del ancla que se descuenta es la que, si los datos ya la informaron, se habría contado dos veces. Con datos reales que discrepen del ancla, λ decide además cuánto se aleja la curva de ella.
Cuánto depende cada celda del ancla o de los datos lo mide dl_etiquetas() (ver Diagnóstico y sensibilidad). Y si la prevalencia ajustada se aleja demasiado de la del ancla, dl_correr() no escribe la corrida, también en la prueba con rapido = TRUE: es la segunda de las dos compuertas, que explica cuándo y cómo aceptar un error mayor.
Cómo entra cada dato
Cada dato se compara con la cantidad del modelo promediada en su intervalo de edad, con los pesos de la población: la prevalencia p para prevalencia, la incidencia poblacional i (1 − p) para incidencia y la mortalidad por la causa p f para mortalidad. Un dato con valor y error_estandar entra con una verosimilitud log-normal, centrada en su valor y con su error; uno con casos y muestra, con una binomial (prevalencia) o una Poisson (incidencia y mortalidad), con muestra_efectiva en lugar de muestra si se da. La guía El modelo escribe cada término. Si el intervalo de un dato cruza bandas de la población con distinto número de edades (un dato de todas las edades, o de 60 años y más, sobre quinquenios y una banda de 80 años y más), cada edad lleva la población de su banda repartida entre las edades de esa banda: la banda ancha cuenta por su población y no pesa de más frente a una de cinco años.
Con casos y muestra, la incertidumbre sale del tamaño de la muestra; con valor y error estándar, del error que se declara. La forma del dato y su incertidumbre deben ser las de la fuente: no conviene convertir un valor publicado en conteos inventando la muestra. Si algún dato con valor vale 0, la log-normal necesita un desplazamiento η > 0, que se declara en avanzado: {offset_lognormal: ...}.
Excluir un dato
Un dato que no se quiere usar (un valor atípico, una definición de caso distinta) no se borra: se marca con excluir: TRUE y su motivo, que queda registrado. En el ejemplo, un estudio de prevalencia de mujeres de 65 a 69 años vale mucho más que sus vecinos y está excluido:
datos[excluir == TRUE, .(medida, sexo, edad_inicio, edad_fin, valor, error_estandar, motivo)]
#>         medida    sexo edad_inicio edad_fin     valor error_estandar
#>         <char>  <char>       <int>    <int>     <num>          <num>
#> 1: prevalencia mujeres          65       70 0.1356914     0.02713828
#>                                     motivo
#>                                     <char>
#> 1: valor atípico sintético para el ejemplo
Con datos en el ajuste, un dato excluido sin motivo detiene dl_insumos(). Aquí, en la copia peso05, con el motivo borrado:
datos_peso05 <- fread(file.path(peso05, "datos.csv"), colClasses = "character", encoding = "UTF-8")
datos_peso05[excluir == "TRUE", motivo := NA]
fwrite(datos_peso05, file.path(peso05, "datos.csv"))
dl_insumos(dl_proyecto(peso05, causa = 9100))
#> Error:
#> ! dl_insumos(): la tabla datos tiene 1 problema(s):
#>   - datos: un dato marcado para excluir exige su motivo: fila(s) 26
Excluir un dato es una decisión que se documenta: el motivo va en datos.csv y, si hace falta explicarla más, en notas.
Lista de comprobación
Siguientes pasos
- Estimación subnacional: los datos subnacionales reservados para validar.
-
Subtipos y suma: varias causas en un proyecto, con la tabla
datoscompartida. - El modelo: la log-posterior completa y el papel de λ.
- Preparar tus datos: las tablas del proyecto y de dónde sale cada una.