
library(dismodlite)
list.files(dl_ejemplo(), recursive = TRUE)
#>  [1] "ancla/sintetico_acs_v1.csv"         "betas.csv"
#>  [3] "config/9100.yaml"                   "config/9101.yaml"
#>  [5] "config/9102.yaml"                   "config/9103.yaml"
#>  [7] "covariables/HAQI.csv"               "covariables/LDI_PC.csv"
#>  [9] "covariables/SEV_SCALAR_CVD_PVD.csv" "datos.csv"
#> [11] "LEEME.md"                           "poblacion.csv"
#> [13] "proxies_crudos.csv"                 "severidad.csv"
#> [15] "ubicaciones.csv" "verdad.csv"Qué vas a aprender
Esta guía recorre el proyecto de ejemplo del paquete de principio a fin:
- qué es un proyecto y qué trae el de ejemplo;
- cómo revisarlo antes de correrlo, con
dl_revisar_proyecto(); - cómo correrlo en una llamada, con
dl_correr(), y qué deja en la carpeta de la corrida; - cómo hacer el ajuste nacional paso a paso y resumirlo con
dl_estimaciones(); - cómo leer los diagnósticos de convergencia;
- cómo comparar la estimación con la curva verdadera, que en el ejemplo se conoce.
Todo el código de la guía corre en menos de un minuto.
1. El proyecto de ejemplo
dismodlite trabaja con proyectos: una carpeta por enfermedad (o por grupo de causas) con una configuración corta y unas pocas tablas. El paquete trae uno completo, dl_ejemplo(), listo para leer y para copiar como punto de partida.
Todos sus números son sintéticos. La enfermedad es inventada, la arteriopatía crónica sintética (ACS en los nombres de los archivos; causa 9100, suma de tres subtipos: 9101, 9102 y 9103). La geografía es la de un país real, Perú, con sus 25 departamentos como ubicaciones subnacionales, pero ningún número describe a ese país. Como los datos se generaron a partir de curvas conocidas, al final podremos comprobar si el modelo las recupera.
Los archivos, en breve (son las tablas del contrato de insumos; la guía Preparar tus datos las describe columna por columna):
-
config/<causa>.yaml: la configuración de cada causa. Un proyecto de una sola causa tieneconfig.yaml. -
ubicaciones.csv: la ubicación nacional (código123) y las 25 subnacionales. -
poblacion.csv: la población por ubicación, año, sexo y banda de edad. -
ancla/: la estimación de referencia, el ancla, tal como se descarga de GBD Results. -
covariables/: los valores nacionales de las covariables, tal como se descargan del GHDx. -
proxies_crudos.csv: una encuesta con tres ediciones que mide cada covariable por ubicación subnacional. El paquete la calibra al leer el proyecto: de ahí salen los valores subnacionales de las covariables, que dan las diferencias entre ubicaciones. -
betas.csv: el efecto publicado de cada covariable. -
datos.csv: los datos locales (estudios, registros). -
severidad.csv: los estados de salud de cada causa y sus pesos de discapacidad, para los AVD. -
verdad.csv: las curvas verdaderas del ejemplo. No es un insumo: sirve para comparar.
La configuración de la causa 9100 es corta:
cat(readLines(dl_ejemplo("config", "9100.yaml"), encoding = "UTF-8"), sep = "\n")
# Arteriopatía crónica sintética (causa 9100): configuración de ejemplo con datos sintéticos.
# Las claves que no aparecen toman su valor por defecto: ver ?dl_configuracion y print(dl_proyecto(...)).
causa: 9100
nombre: Arteriopatía crónica sintética
anio: 2023
edad_inicio: 30

mortalidad_exceso:
  techo: 0.25                  # por persona-año

subnacional:
  anio_validacion: 2019          # año de los datos subnacionales reservados para validar

proxies:                         # la calibración de proxies_crudos.csv (?dl_calibrar_proxies)
  transformacion:
    haqi: diferencia             # un índice de 0 a 100: en puntos; el SEV y el LDI, en cociente

sensibilidad:
  peso: [0.1, 0.5, 1.0]

subtipos: [9101, 9102, 9103]

notas:
  - Datos sintéticos de ejemplo (dismodlite).
dl_proyecto() lee la carpeta para una causa y muestra qué tablas encontró y qué claves de la configuración tomaron su valor por defecto (la lista completa de claves, con su significado, está en ?dl_configuracion):
proyecto <- dl_proyecto(dl_ejemplo(), causa = 9100)
proyecto
#> <dl_proyecto> Arteriopatía crónica sintética, causa 9100 | año 2023 | tablas del contrato
#>   carpeta: /home/runner/work/_temp/Library/dismodlite/extdata/acs_peru
#>   tablas:
#>     ubicaciones             26 fila(s), de ubicaciones.csv
#>     poblacion               2100 fila(s), de poblacion.csv
#>     ancla                   768 fila(s), de ancla
#>     covariables             8 fila(s), de covariables
#>     betas                   3 fila(s), de betas.csv
#>     datos                   185 fila(s), de datos.csv
#>     severidad               12 fila(s), de severidad.csv
#>     fuentes_gbd             no
#>     poblacion_detalle       no
#>     proxies_crudos          1500 fila(s), de proxies_crudos.csv
#>     razones                 no
#>     prior_mortalidad_exceso no
#>   subnacional: covariables
#>   proxies calibrados de proxies_crudos (año 2023):
#>     SEV_scalar_agestd_cvd_pvd: paseo_aleatorio, q = 2.26e-05, ediciones 2019, 2021, 2023
#>     LDI_pc: paseo_aleatorio, q = 0.000373, ediciones 2019, 2021, 2023
#>     haqi: paseo_aleatorio, q = 0.406, ediciones 2019, 2021, 2023
#>   tomado por defecto (14):
#>     sexos = [hombres, mujeres]
#>     ubicacion_gbd = 123
#>     ancla.peso (λ) = 1
#>     ancla.correlacion_edad (ρ) = 0.5
#>     ancla.anio = 2023
#>     nudos = [30, 40, 50, 60, 70, 80, 95]
#>     incidencia.suavidad (σ) = 0.5
#>     mortalidad_exceso.prior = desde_ancla
#>     remision = 0
#>     datos_en_ajuste = ninguno: las nacionales no se usan; las subnacionales de mortalidad validan
#>     subnacional.modo = covariables
#>     subnacional.kappa (κ) = 1
#>     sensibilidad.correlacion_edad (ρ) = [0, 0.5, 0.9]
#>     sensibilidad.kappa (κ) = [0.5, 1]
2. Revisar el proyecto
Antes de correr, dl_revisar_proyecto() comprueba cada tabla y la configuración, y al final arma los insumos completos con las reglas que cruzan tablas (por ejemplo, que la población nacional sea la suma de las subnacionales). No se detiene en el primer problema: muestra una línea por comprobación, con ✓ si está en orden, ! si es un aviso que conviene mirar y ✗ si es un error, junto con la corrección sugerida.
dl_revisar_proyecto(dl_ejemplo(), causa = 9100)
#> Revisión del proyecto «acs_peru», causa 9100
#>   ✓ ubicaciones: leída: 26 fila(s)
#>   ✓ poblacion: leída: 2100 fila(s)
#>   ✓ ancla: leída: 768 fila(s) (descarga de GBD Results)
#>   ✓ covariables: leída: 8 fila(s) (descarga de covariables del GHDx)
#>   ✓ betas: leída: 3 fila(s)
#>   ✓ datos: leída: 185 fila(s)
#>   ✓ severidad: leída: 12 fila(s)
#>   ✓ proxies_crudos: leída: 1500 fila(s)
#>   ✓ proxies: SEV_scalar_agestd_cvd_pvd: paseo_aleatorio, q = 2.26e-05, ediciones 2019, 2021, 2023
#>       LDI_pc: paseo_aleatorio, q = 0.000373, ediciones 2019, 2021, 2023
#>       haqi: paseo_aleatorio, q = 0.406, ediciones 2019, 2021, 2023
#>   ✓ configuración: config/9100.yaml: proyecto
#>   ✓ proyecto: las reglas entre tablas se cumplen
#>   ✓ insumos: dl_insumos() los arma y los valida (hash 0e52c7277b9a)
#> Todo en orden.
Además de imprimir, devuelve (sin mostrarla) una tabla con una fila por comprobación, útil para guardar o filtrar.
3. Correr el proyecto con dl_correr()
dl_correr() hace la corrida completa de una causa en una llamada: arma los insumos, ajusta el modelo nacional, lo lleva a las ubicaciones subnacionales, lo valida contra el ancla, calcula los AVD y los diagnósticos, resume y escribe la carpeta de la corrida. La semilla es obligatoria: la misma semilla da siempre los mismos números.
Con rapido = TRUE es una prueba: cadenas cortas para comprobar en segundos que el proyecto corre de principio a fin. Aquí además se omite el análisis de sensibilidad (sensibilidad = FALSE), que es lo más lento, y la corrida se escribe en una carpeta temporal:
salida <- file.path(tempdir(), "resultados")
corrida <- dl_correr(dl_ejemplo(), causa = 9100, semilla = 1, rapido = TRUE, sensibilidad = FALSE,
                     carpeta_salida = salida)
#> dl_correr(): corrida de prueba (rapido = TRUE): 2 cadena(s) de 2000 iteraciones y forzar = TRUE, que la escribe aunque las cadenas no converjan. Sus números no sirven para publicar: para la corrida final, rapido = FALSE
#> dl_correr(): causa 9100: insumos
#> dl_correr(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
#> dl_correr(): ajuste nacional: 2 cadena(s) de 2000 iteraciones por sexo (motor mh)
#> dl_correr(): cascada subnacional
#> dl_correr(): validación contra el ancla y AVD
#> dl_correr(): etiquetas de cuánto informan los datos
#> dl_correr(): corrida escrita en /tmp/RtmpeeAv8R/resultados/mod/dismod_lite/2026-10-15_causa-9100-prueba_v1 (prueba: no sirve para publicar)
Cada mensaje nombra el paso en curso. El primero recuerda que es una prueba: sus cadenas no alcanzan a converger y la corrida se escribe igual (con forzar = TRUE, declarado en su manifiesto), con un nombre que termina en -prueba. Sus números no sirven para publicar. La corrida de producción es la misma llamada sin rapido:
corrida <- dl_correr(dl_ejemplo(), causa = 9100, semilla = 1)Usa 1000 simulaciones y 4 cadenas de 50 000 iteraciones, corre la sensibilidad y tarda bastante más: con este ejemplo, unos 5 minutos en una computadora reciente, con un solo núcleo y el motor por defecto (la guía Diagnóstico y sensibilidad explica cómo acortarlo). Solo escribe la corrida si pasa dos compuertas: que las cadenas hayan convergido y que la prevalencia ajustada se parezca a la del ancla (la prueba solo exige la segunda). Si no, se detiene y dice qué cambiar.
Dos argumentos más de dl_correr(), para cuando el proyecto sea el tuyo:
-
anioscorre la causa para varios años sin editar la configuración, y devuelve una corrida por año:dl_correr("mi_proyecto", semilla = 1, anios = 2018:2023). -
forzar = TRUEescribe la corrida aunque las cadenas no hayan convergido (el manifiesto lo declara), para mirarla mientras se afinan las cadenas; no salta la compuerta del ancla.
Y para correr todas las causas de un proyecto, un bucle sobre sus configuraciones. Las causas que son la suma de sus subtipos (suma_de_subtipos: sí) van al final, porque dl_correr() las suma con las corridas de los subtipos que encuentra ya escritas:
archivos <- list.files(file.path("mi_proyecto", "config"), full.names = TRUE)
causas <- as.integer(sub("[.]yaml$", "", basename(archivos)))
es_suma <- vapply(archivos, function(archivo) {
  suma <- yaml::read_yaml(archivo)$suma_de_subtipos        # «sí» se lee como texto; «no», como FALSE
  !is.null(suma) && !isFALSE(suma)
}, NA)
for (causa in causas[order(es_suma)]) dl_correr("mi_proyecto", causa = causa, semilla = 1)
La guía Corridas, versiones y tablas consolidadas desarrolla los tres.
La carpeta de la corrida
La corrida queda en <carpeta_salida>/mod/dismod_lite/<run_id>/, con run_id el nombre de la corrida (la fecha, un nombre corto y la versión). Sin carpeta_salida, se escribe en la carpeta resultados/ del proyecto.
corrida
#> <dl_run> corrida 2026-10-15_causa-9100-prueba_v1 (cascada subnacional)
#>   carpeta: /tmp/RtmpeeAv8R/resultados/mod/dismod_lite/2026-10-15_causa-9100-prueba_v1
#>   3 particiones canónicas (una por medida) | exportada con forzar = TRUE
list.files(corrida$dir, recursive = TRUE)
#>  [1] "cause/incidence/2026-10-15_causa-9100-prueba_v1.csv"
#>  [2] "cause/prevalence/2026-10-15_causa-9100-prueba_v1.csv"
#>  [3] "cause/yld/2026-10-15_causa-9100-prueba_v1.csv"
#>  [4] "diagnostics/aceptacion.csv"
#>  [5] "diagnostics/amplitud.csv"
#>  [6] "diagnostics/desplazamiento_splits.csv"
#>  [7] "diagnostics/dx_bandas.csv"
#>  [8] "diagnostics/mcmc.csv"
#>  [9] "diagnostics/proxies_series.csv"
#> [10] "diagnostics/renorm.csv"
#> [11] "diagnostics/validacion.csv"
#> [12] "draws/incidence_2023.csv.gz"
#> [13] "draws/prevalence_2023.csv.gz"
#> [14] "draws/yld_2023.csv.gz"
#> [15] "etiquetas/2026-10-15_causa-9100-prueba_v1.csv"
#> [16] "inputs/betas.csv"
#> [17] "inputs/config_usado.yaml"
#> [18] "inputs/contrato/ancla.csv"
#> [19] "inputs/contrato/betas.csv"
#> [20] "inputs/contrato/config.yaml"
#> [21] "inputs/contrato/covariables.csv"
#> [22] "inputs/contrato/datos.csv"
#> [23] "inputs/contrato/poblacion.csv"
#> [24] "inputs/contrato/proxies_crudos.csv"
#> [25] "inputs/contrato/severidad.csv"
#> [26] "inputs/contrato/ubicaciones.csv"
#> [27] "inputs/cov_proxy.csv"
#> [28] "inputs/cov_valores.csv"
#> [29] "inputs/crosswalks.csv"
#> [30] "inputs/datos.csv"
#> [31] "inputs/hash.json"
#> [32] "inputs/poblacion.csv"
#> [33] "inputs/prior_gbd.csv"
#> [34] "inputs/sequela_map.csv"
#> [35] "inputs/severidad.csv"
#> [36] "manifest.yaml"
Lo principal:
-
cause/<medida>/: una tabla por medida (prevalencia, incidencia y AVD) con la media (val) y el intervalo del 95 % (lower,upper) de cada ubicación, sexo y grupo de edad, con los nombres de columna de las descargas de GBD. -
manifest.yaml: qué se corrió, con qué opciones, con qué insumos y qué claves se tomaron por defecto.
Las demás carpetas (las simulaciones, los diagnósticos, las etiquetas y los insumos) las describe la guía Corridas, versiones y tablas consolidadas.
La tabla de prevalencia trae la ubicación nacional y las 25 subnacionales. Sus grupos de edad son los del ancla, tal como vienen (de 40-44 a 95 años y más): por eso empieza en 40-44 años aunque edad_inicio sea 30. Las edades de 30 a 39 se modelan, pero no se informan en las tablas; dl_estimaciones() (sección 6) da cada edad simple desde edad_inicio. Al leer la tabla conviene tratar location_id como texto, para que un código como 01 no se convierta en el número 1:
archivo <- list.files(file.path(corrida$dir, "cause", "prevalence"), full.names = TRUE)
tabla <- read.csv(archivo, colClasses = c(location_id = "character"), encoding = "UTF-8")
columnas <- c("location_id", "location_name", "sex_id", "age_group_name", "val", "lower", "upper")
head(tabla[tabla$location_id == "123", columnas])
#>   location_id location_name sex_id age_group_name        val       lower
#> 1         123          Perú      1    40-44 years 0.01274434 0.009321281
#> 2         123          Perú      1    45-49 years 0.01897328 0.015643420
#> 3         123          Perú      1    50-54 years 0.02581334 0.021226377
#> 4         123          Perú      1    55-59 years 0.03340600 0.027504514
#> 5         123          Perú      1    60-64 years 0.04196389 0.034660406
#> 6         123          Perú      1    65-69 years 0.05226160 0.043213559
#>        upper
#> 1 0.01653482
#> 2 0.02291474
#> 3 0.03130308
#> 4 0.04002152
#> 5 0.05038544
#> 6 0.05996622
head(tabla[tabla$location_id == "01", columnas], 3)
#>    location_id location_name sex_id age_group_name        val      lower
#> 25          01      Amazonas      1    40-44 years 0.01398684 0.01016707
#> 26          01      Amazonas      1    45-49 years 0.02061131 0.01647353
#> 27          01      Amazonas      1    50-54 years 0.02776666 0.02292320
#>         upper
#> 25 0.01834765
#> 26 0.02456013
#> 27 0.03323818
La estimación subnacional tiene su propia guía en el sitio del paquete: Estimación subnacional.
4. Paso a paso: el ajuste nacional
Cada paso de dl_correr() es también una función. Hacerlos a mano sirve para entender el modelo, probar opciones y mirar los resultados intermedios. Primero, los insumos: dl_insumos() lee todas las tablas del proyecto, las valida y las deja listas para el modelo.
insumos <- dl_insumos(proyecto)
#> dl_insumos(): 25 fila(s) nacionales de la tabla datos quedan fuera del ajuste porque datos_en_ajuste está vacío en la configuración; las filas subnacionales se usan solo para validar la cascada
insumos
#> <dl_bundle> insumos de la causa 9100 (Arteriopatía crónica sintética) | ancla en la ubicación 123 | hash 0e52c7277b9a
#>   datos          160 filas  datos locales (para el ajuste o la validación)
#>   prior_gbd       48 filas  ancla, por medida, sexo y banda de edad
#>   betas            3 filas  betas de las covariables
#>   cov_valores      8 filas  valores nacionales de las covariables
#>   cov_proxy      500 filas  valores subnacionales de las covariables (proxies)
#>   severidad        3 filas  estados de salud de la causa
#>   poblacion      728 filas  población por ubicación, sexo y edad
#>   sequela_map      0 filas  secuelas de la causa (formato completo)
print() muestra una línea por tabla de los insumos (el ancla, los datos locales, las covariables, la severidad, la población…), con su número de filas; ?dl_insumos describe cada una.
El mensaje explica algo importante del ejemplo: su configuración no declara datos_en_ajuste, así que los datos locales nacionales no entran al ajuste; las filas subnacionales sirven solo para validar. El ajuste queda informado solo por el ancla. La guía Datos locales muestra cómo cambia eso.
El ajuste nacional se hace por sexo con cadenas de Markov (MCMC). dl_opciones_mcmc() fija cuántas simulaciones se guardan y cuántas cadenas e iteraciones se corren. Aquí son las cadenas cortas de la prueba de arriba (las de rapido = TRUE):
opciones <- dl_opciones_mcmc(simulaciones = 100, cadenas = 2, iteraciones = 2000, calentamiento = 1000)
opciones
#> <dl_mcmc_opts> simulaciones 100 | cadenas 2 | iteraciones 2000 | calentamiento 1000 | adelgazamiento 10 | núcleos 1 | motor mh
ajuste <- dl_ajustar(insumos, opciones, semilla = 1)
ajuste
#> <dl_fit> insumos 0e52c7277b9a | semilla 1 | motor mh
#>   sexos: 1, 2 | simulaciones por sexo: 100 | edades 30-99
#>   R-hat máximo 2.306 | ESS mínimo 11 | aceptación 0.26-1.00
El ajuste sale al instante porque ya lo hizo dl_correr(): los ajustes quedan guardados en la sesión, y dl_ajustar() con los mismos insumos, opciones y semilla devuelve el guardado sin volver a muestrear.
5. ¿Convergieron las cadenas?
print() resume la convergencia con dos números por ajuste:
- R-hat compara la variación entre las cadenas (y entre las dos mitades de cada una) con la variación dentro de ellas; cerca de 1 indica que todas muestrean la misma distribución.
- ESS (tamaño efectivo de muestra) es el número de simulaciones independientes que equivalen a las guardadas; cuanto mayor, más precisas la media y los intervalos.
La tabla ajuste$mcmc los da por parámetro: el logaritmo de la incidencia (logi_<edad>) y de la mortalidad en exceso (logf_<edad>) en cada nudo, por sexo. Los peores primero:
Para escribir una corrida de producción, dismodlite exige R-hat < 1.01 y ESS ≥ 400 en todos los parámetros. Con cadenas tan cortas no se cumple, y es lo esperado: se corrige alargando las cadenas (iteraciones, calentamiento) o con más cadenas. La guía Diagnóstico y sensibilidad explica cómo elegirlas.
6. Las estimaciones
dl_estimaciones() resume las simulaciones en una tabla con la media y el intervalo del 95 % de cada edad y sexo. Por defecto da la prevalencia (una proporción); también da la incidencia (casos nuevos por persona-año de toda la población) y la mortalidad en exceso (muertes por la enfermedad por persona-año de quienes la tienen):
prevalencia <- dl_estimaciones(ajuste)
head(prevalencia)
#>    location_id sex_id  edad      medida        media     inferior    superior
#>         <char>  <int> <int>      <char>        <num>        <num>       <num>
#> 1:         123      1    30 prevalencia 0.0000000000 0.0000000000 0.000000000
#> 2:         123      1    31 prevalencia 0.0009713892 0.0004834718 0.001674911
#> 3:         123      1    32 prevalencia 0.0019514261 0.0010106230 0.003300012
#> 4:         123      1    33 prevalencia 0.0029423464 0.0015789707 0.004877413
#> 5:         123      1    34 prevalencia 0.0039464232 0.0021877604 0.006410696
#> 6:         123      1    35 prevalencia 0.0049659840 0.0028435334 0.007903400
incidencia <- dl_estimaciones(ajuste, "incidencia")
mortalidad_exceso <- dl_estimaciones(ajuste, "mortalidad_exceso")
La curva verdadera del ejemplo está en verdad.csv: la prevalencia p, la incidencia entre quienes no tienen la enfermedad i y la mortalidad en exceso f, por edad simple. La incidencia de toda la población es i (1 - p), la misma que da dl_estimaciones().
verdad <- read.csv(dl_ejemplo("verdad.csv"))
verdad <- verdad[verdad$cause_id == 9100 & verdad$location_id == 123 & verdad$anio == 2023, ]
verdad$incidencia <- verdad$i * (1 - verdad$p)
Una función pequeña dibuja una medida con su intervalo y la curva verdadera:
dibujar <- function(estimacion, verdadera, titulo, escala = 100, unidad = "Prevalencia (%)", ymax = NULL) {
  ymax <- if (is.null(ymax)) escala * max(estimacion$superior, verdadera) else ymax
  plot(NA, xlim = range(estimacion$edad), ylim = c(0, ymax), xlab = "Edad (años)", ylab = unidad,
       main = titulo, font.main = 1, bty = "n", las = 1)
  abline(h = pretty(c(0, ymax)), col = "grey92")
  polygon(c(estimacion$edad, rev(estimacion$edad)), escala * c(estimacion$inferior, rev(estimacion$superior)),
          col = adjustcolor("#2a78d6", 0.25), border = NA)
  lines(estimacion$edad, escala * estimacion$media, col = "#2a78d6", lwd = 2)
  lines(estimacion$edad, escala * verdadera, col = "#eb6834", lwd = 2, lty = 2)
}
leyenda <- function() legend("topleft", c("Media e intervalo del 95 %", "Curva verdadera"),
                             col = c("#2a78d6", "#eb6834"), lwd = 2, lty = c(1, 2), bty = "n", cex = 0.8)
sinteticos <- function(texto) mtext(paste("Datos sintéticos:", texto), side = 1, outer = TRUE, adj = 1,
                                    cex = 0.75, col = "grey35")
op <- par(mfrow = c(1, 2), mar = c(4, 4.2, 2.5, 1), oma = c(1.5, 0, 0, 0))
ymax <- 100 * max(prevalencia$superior)
for (sexo in 1:2) {
  dibujar(prevalencia[prevalencia$sex_id == sexo, ], verdad$p[verdad$sex_id == sexo], c("Hombres", "Mujeres")[sexo],
          ymax = ymax)
  if (sexo == 1) leyenda()
}
sinteticos("arteriopatía crónica sintética, nivel nacional, 2023")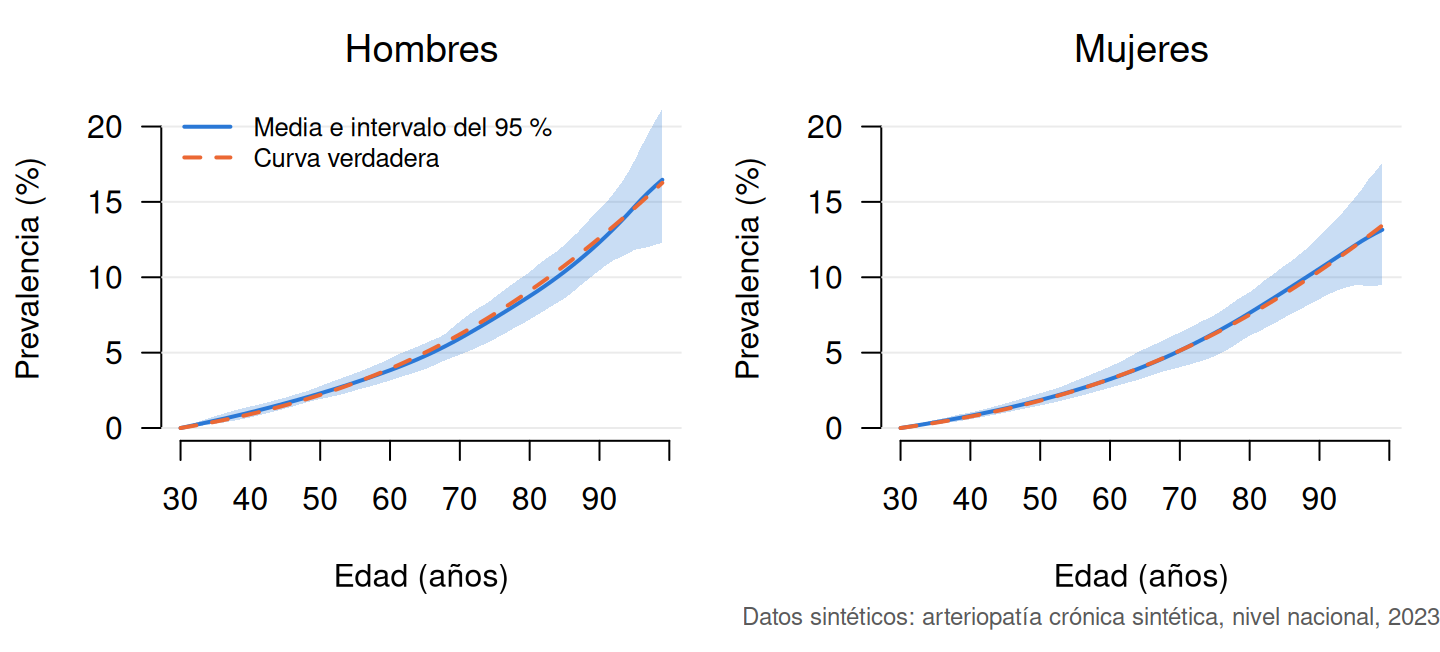
par(op)La línea azul es la media de las simulaciones y la banda, su intervalo del 95 %. La línea naranja discontinua es la curva verdadera. El intervalo se ensancha con la edad, sobre todo después de los 80 años, donde los nudos están más separados (80 y 95); cada banda del ancla de esas edades (80-84, 85-89, 90-94 y 95 y más) entra al ajuste por separado, con su propia incertidumbre.
Las tasas, para los hombres, por 1000 personas-año:
op <- par(mfrow = c(1, 2), mar = c(4, 4.2, 2.5, 1), oma = c(1.5, 0, 0, 0))
hombres <- verdad$sex_id == 1
dibujar(incidencia[incidencia$sex_id == 1, ], verdad$incidencia[hombres], "Incidencia",
        escala = 1000, unidad = "Por 1000 personas-año")
leyenda()
dibujar(mortalidad_exceso[mortalidad_exceso$sex_id == 1, ], verdad$f[hombres], "Mortalidad en exceso",
        escala = 1000, unidad = "Por 1000 personas-año")
sinteticos("arteriopatía crónica sintética, hombres, nivel nacional, 2023")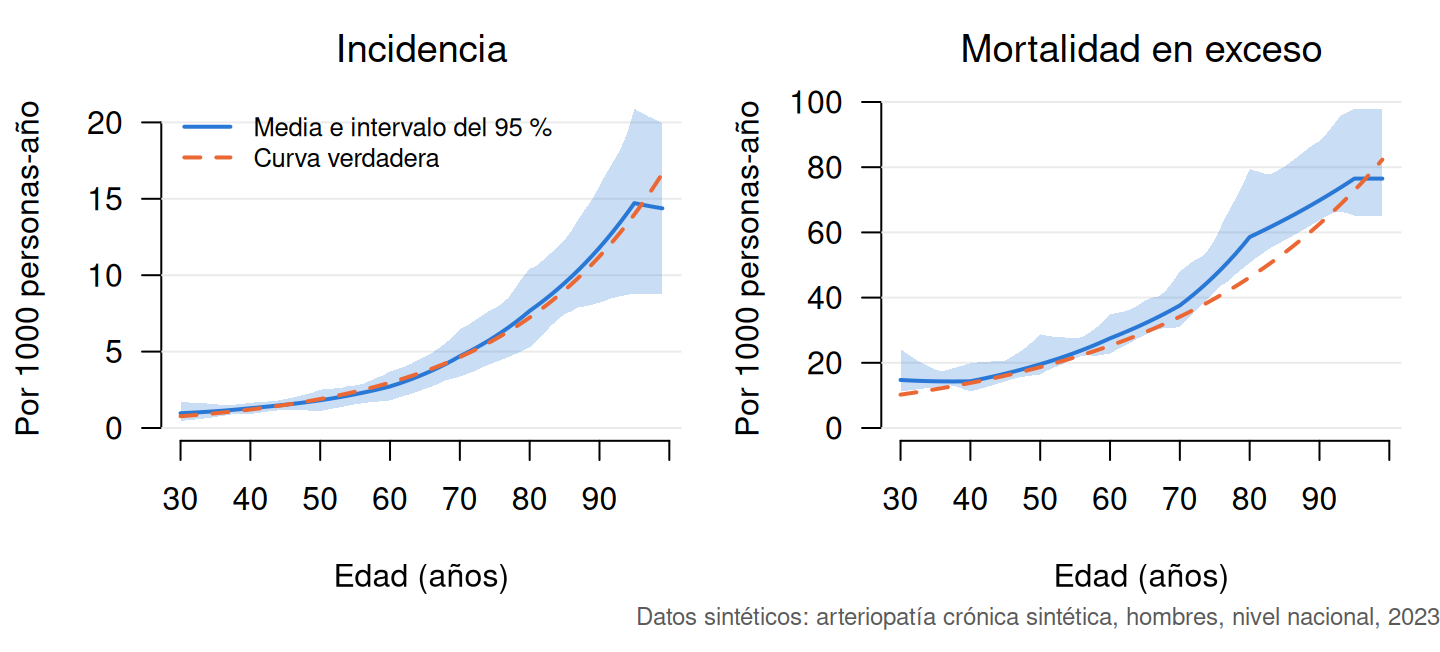
par(op)La incidencia queda bien determinada: es la que explica cómo crece la prevalencia con la edad. La mortalidad en exceso, en cambio, la informa sobre todo su prior por edad, que sale de las muertes y la prevalencia del ancla (las muertes por persona-año divididas por la prevalencia), y un techo. Por eso su intervalo es más ancho y, después de los 95 años, el último nudo, la curva queda plana. Datos locales de mortalidad en el ajuste la precisarían. La guía El modelo explica cada una de estas piezas.
7. ¿Recupera la curva verdadera?
Unimos las estimaciones de prevalencia con la curva verdadera y medimos dos cosas: en qué fracción de las edades la curva verdadera cae dentro del intervalo, y la diferencia relativa entre la media y la verdad a algunas edades.
comparacion <- merge(as.data.frame(prevalencia)[, c("sex_id", "edad", "media", "inferior", "superior")],
                     verdad[, c("sex_id", "edad", "p")], by = c("sex_id", "edad"))
comparacion <- comparacion[comparacion$edad > 30, ]   # a los 30 años la prevalencia es 0 por construcción
cubre <- comparacion$p >= comparacion$inferior & comparacion$p <= comparacion$superior
round(tapply(cubre, comparacion$sex_id, mean), 2)     # fracción de edades cubiertas, por sexo
#> 1 2
#> 1 1
comparacion$dif_relativa <- round(comparacion$media / comparacion$p - 1, 3)
comparacion[comparacion$edad %in% c(40, 60, 80), c("sex_id", "edad", "p", "media", "dif_relativa")]
#>     sex_id edad          p       media dif_relativa
#> 11       1   40 0.00919955 0.010383361        0.129
#> 31       1   60 0.03934130 0.038332875       -0.026
#> 51       1   80 0.09103360 0.087464025       -0.039
#> 81       2   40 0.00761560 0.008091129        0.062
#> 101      2   60 0.03251250 0.032445054       -0.002
#> 121      2   80 0.07518060 0.076375632        0.016
La estimación recupera la curva verdadera con diferencias pequeñas frente al ancho del intervalo. Conviene entender por qué: en el ejemplo, el ancla es una medición con ruido de la misma curva verdadera y, como ningún dato local entra al ajuste, el resultado sigue al ancla. Con datos propios que sí entren, el modelo combina ambas fuentes según su precisión; la guía Datos locales lo muestra con este mismo ejemplo.
Siguientes pasos
-
Preparar tus datos: cómo armar un proyecto propio, tabla por tabla, con
dl_nuevo_proyecto()ydl_revisar_proyecto(). - El modelo: las ecuaciones detrás de cada número de esta guía.
- En el sitio del paquete (https://horaciochacon.github.io/dismodlite/), las guías de cada tema: Estimación subnacional, Datos locales, Carga: los años vividos con discapacidad y Diagnóstico y sensibilidad.
- Cambia
simulaciones,cadenaseiteracionesendl_opciones_mcmc()y mira cómo cambian R-hat, ESS y el ancho de los intervalos.