
library(dismodlite)
proyecto <- dl_ejemplo(copiar_en = file.path(tempdir(), "proyecto_diagnostico"))Qué vas a aprender
- A leer la convergencia de un ajuste: R-hat, tamaño efectivo (ESS) y tasas de aceptación.
- Qué son las dos compuertas que una corrida debe pasar antes de escribirse.
- A validar el ajuste contra el ancla con
dl_validar_ancla(), también en las ubicaciones subnacionales. - Qué dicen las etiquetas de
dl_etiquetas()sobre cuánto informan los datos locales cada celda. - A medir la sensibilidad de las estimaciones a λ, ρ y κ con
dl_sensibilidad(). - A elegir las cadenas, cuánto tarda una corrida de producción y cuándo conviene el motor
"rcpp"o varios núcleos.
Usamos una copia del proyecto de ejemplo (datos sintéticos) con una variante: los datos locales nacionales entran al ajuste (datos_en_ajuste) y el ancla pesa la mitad (ancla.peso: 0.5), para que las etiquetas y la sensibilidad a λ tengan algo que mostrar. Las cadenas son cortas para que la guía corra en segundos; los números de una corrida de producción aparecen en el texto.
Su configuración, config/9100.yaml:
causa: 9100
anio: 2023
edad_inicio: 30

ancla:
  peso: 0.5

mortalidad_exceso:
  techo: 0.25

datos_en_ajuste: [prevalencia, incidencia, mortalidad]

subnacional:
  anio_validacion: 2019

notas:
  - ancla.peso 0.5 porque los datos locales pueden haber informado la estimación de referencia.
insumos <- dl_insumos(dl_proyecto(proyecto, causa = 9100))Convergencia de un ajuste
dl_ajustar() recorre la posterior con varias cadenas de Metropolis-Hastings por sexo. Los parámetros son el logaritmo de la incidencia (log i) y de la mortalidad en exceso (log f) en los nudos de edad: con los 7 nudos del ejemplo, 14 por sexo. Un ajuste corto, de 4 cadenas (con nucleos = 4, que las corre en paralelo con el mismo resultado):
opciones <- dl_opciones_mcmc(simulaciones = 200, cadenas = 4, iteraciones = 3000, calentamiento = 1000,
                             nucleos = 4)
ajuste <- dl_ajustar(insumos, opciones, semilla = 1)
ajuste
#> <dl_fit> insumos e4f7d4afe020 | semilla 1 | motor mh
#>   sexos: 1, 2 | simulaciones por sexo: 200 | edades 30-99
#>   R-hat máximo 1.997 | ESS mínimo 30 | aceptación 0.24-1.00
ajuste$mcmc trae, por sexo y parámetro, el R-hat y el tamaño efectivo de muestra, calculados con las simulaciones que guarda cada cadena después del calentamiento:
head(ajuste$mcmc)
#>    sex_id parametro     rhat       ess
#>     <int>    <char>    <num>     <num>
#> 1:      1   logi_30 1.116700  38.98289
#> 2:      1   logi_40 1.215954  72.64794
#> 3:      1   logi_50 1.074649  82.83563
#> 4:      1   logi_60 1.056330 115.75768
#> 5:      1   logi_70 1.070451 155.64684
#> 6: 1 logi_80 1.066915 147.75829-
R-hat (partido) compara, para cada parámetro, la varianza entre las mitades de las cadenas con la varianza dentro de ellas. Cerca de 1 indica que todas muestrean la misma distribución; la corrida exige
R-hat < 1.01. -
ESS (tamaño efectivo de muestra) es el número de simulaciones independientes que darían la misma precisión que las simulaciones autocorrelacionadas de las cadenas; la corrida exige
ESS >= 400.
Las fórmulas están en ?dl_rhat y ?dl_ess. Con cadenas tan cortas, varios parámetros no llegan:
mcmc <- as.data.frame(ajuste$mcmc)
mcmc <- mcmc[order(mcmc$sex_id, mcmc$parametro), ]
etiqueta <- paste(ifelse(mcmc$sex_id == 1, "H", "M"), mcmc$parametro)
k <- seq_len(nrow(mcmc))
op <- par(mfrow = c(1, 2), mar = c(5, 8, 3, 1))
plot(mcmc$rhat, k, pch = 19, yaxt = "n", ylab = "", xlab = "R-hat", main = "R-hat", sub = "Datos sintéticos",
     col = ifelse(mcmc$rhat < 1.01, "grey40", "firebrick"))
axis(2, at = k, labels = etiqueta, las = 1, cex.axis = 0.6)
abline(v = 1.01, lty = 2)
plot(mcmc$ess, k, pch = 19, yaxt = "n", ylab = "", xlab = "ESS", main = "Tamaño efectivo",
     sub = "Datos sintéticos", col = ifelse(mcmc$ess >= 400, "grey40", "firebrick"))
axis(2, at = k, labels = etiqueta, las = 1, cex.axis = 0.6)
abline(v = 400, lty = 2)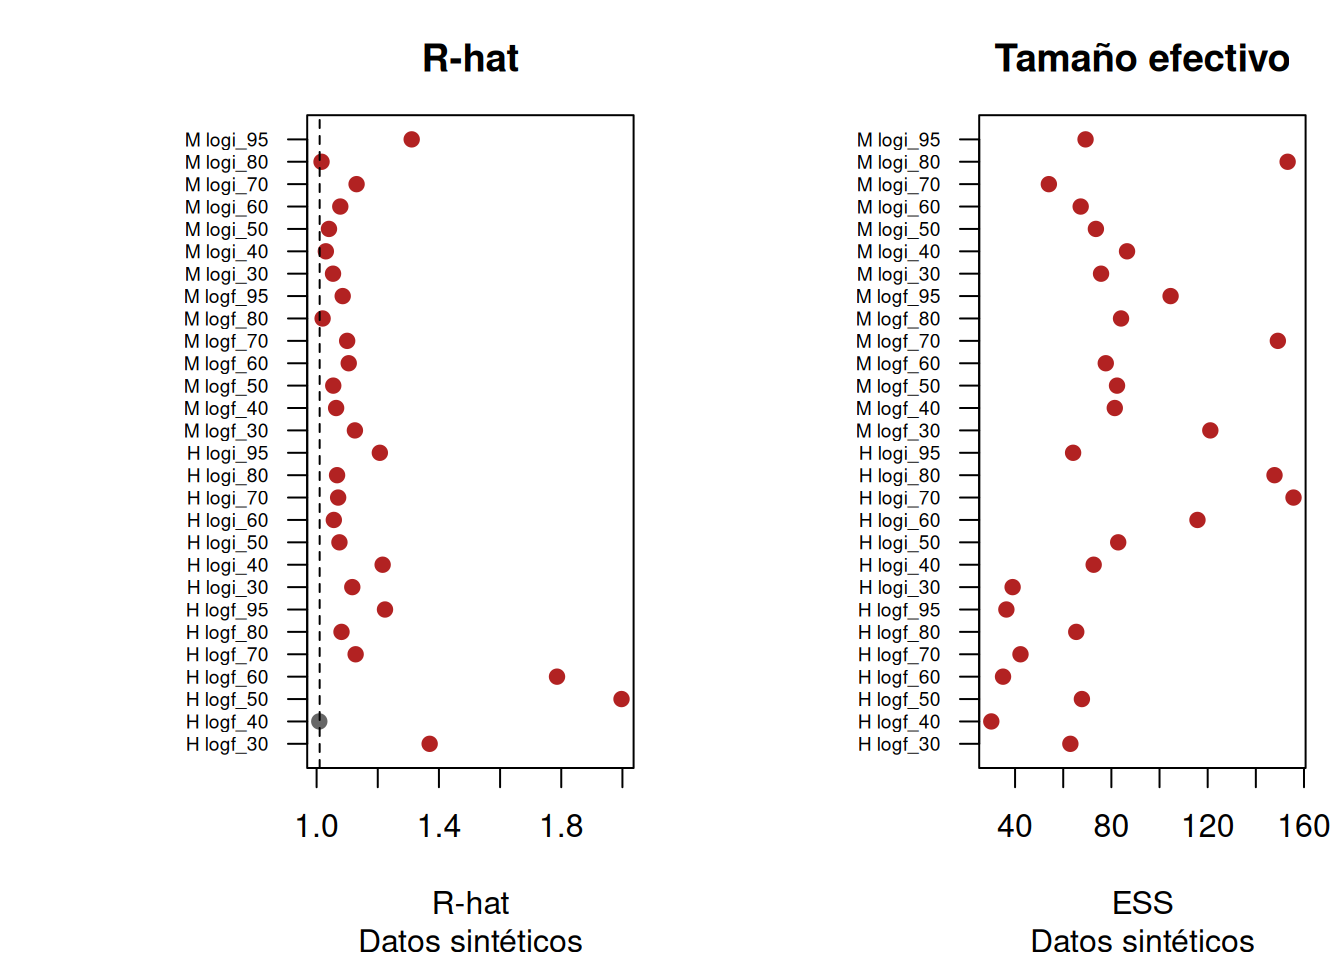
par(op)En rojo, los parámetros que no pasan (H: hombres, M: mujeres). La tasa de aceptación de cada cadena y bloque (bloque 1: log i; bloque 2: log f), después del calentamiento, está en ajuste$aceptacion:
summary(ajuste$aceptacion$tasa)
#>    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
#>  0.2410  0.2904  0.3432  0.4158  0.4368  0.9990
Durante el calentamiento el muestreador ajusta el tamaño de sus propuestas para acercar la aceptación de cada bloque a 0.28; después queda fijo. Una aceptación muy baja (menos de 0.1) indica pasos demasiado grandes para la posterior, y una cercana a 1, pasos demasiado pequeños: la cadena casi siempre acepta, pero avanza muy poco, y su tamaño efectivo es bajo. En los dos casos el calentamiento no alcanzó para adaptar la propuesta y conviene alargarlo.
Las dos compuertas de una corrida
dl_correr() y dl_exportar_corrida() no escriben una corrida que no pase dos comprobaciones:
-
Convergencia:
R-hat < 1.01yESS >= 400en todos los parámetros.dl_correr()la comprueba justo después del ajuste, antes de gastar tiempo en el resto. - Error del ancla: la prevalencia ajustada debe reproducir la del ancla. El error relativo mediano entre ambas, sobre las bandas de edad y los sexos, no debe pasar de 0.05. Se comprueba después de la validación.
Con las cadenas cortas de arriba, la corrida se detiene en la primera, con un mensaje que dice qué hacer (el ajuste no se repite: dl_correr() lo toma de la caché de la sesión):
tryCatch(dl_correr(proyecto, causa = 9100, semilla = 1, opciones = opciones,
                   carpeta_salida = file.path(tempdir(), "resultados")),
         error = function(e) cat(conditionMessage(e), "\n"))
#> dl_correr(): causa 9100: insumos
#> dl_correr(): ajuste nacional: 4 cadena(s) de 3000 iteraciones por sexo (motor mh)
#> dl_correr(): las cadenas no convergieron: R-hat máximo 1.9970 (debe ser < 1.01) y ESS mínimo 30 (debe ser >= 400). Aumenta las iteraciones y el calentamiento con opciones = dl_opciones_mcmc(iteraciones = ..., calentamiento = ...); para una prueba, rapido = TRUE; forzar = TRUE la escribe igual y lo declara en el manifiesto
La corrida de prueba (dl_correr(rapido = TRUE)) y forzar = TRUE, en dl_correr() y en dl_exportar_corrida(), saltan la compuerta de convergencia y lo declaran en el manifiesto: sirven para ver que todo corre, o para mirar una corrida que aún no converge, no para publicar. La del error del ancla no se salta nunca. Con datos locales en el ajuste es la que más importa: la prevalencia ajustada puede alejarse de la del ancla, y ese es justamente el efecto de los datos. Si hay una razón para aceptar un error mayor (los datos locales son mejores que el ancla, o el ancla tiene pocas bandas de edad), se declara en la configuración, con ancla.error_maximo (y la razón en notas):
ancla:
  error_maximo: 0.08
notas:
  - El ancla tiene pocas bandas de edad.
y la corrida lo registra entre sus limitaciones.
Validar contra el ancla
dl_validar_ancla() hace dos comprobaciones nacionales, por sexo y banda de edad:
-
anchor_identity: la prevalencia ajustada frente a la del ancla (la de la segunda compuerta); -
implied_incidence: la incidencia que implica el modelo, i (1 − p), frente a la incidencia del ancla, que no entra al ajuste. Es una prueba de consistencia: con el prior de la mortalidad en exceso por defecto, mide si las medidas de la estimación de referencia son coherentes entre sí bajo el modelo.
Con una estimación subnacional (cascada) y mortalidad subnacional reservada para validar en datos.csv (las filas subnacionales del año subnacional.anio_validacion), agrega la validación de amplitud:
cascada <- dl_cascada(ajuste, insumos, semilla = 1)
validacion <- dl_validar_ancla(ajuste, insumos, cascada = cascada)
attr(validacion, "resumen")
#>                check err_rel_mediano cobertura
#>               <char>           <num>     <num>
#> 1:   anchor_identity      0.03328041 0.9583333
#> 2: implied_incidence      0.07072839 1.0000000
err_rel_mediano es el error relativo mediano y cobertura, la fracción de bandas en que el valor del ancla cae dentro del intervalo del 95 % del modelo. Aquí el error de la prevalencia es 0.033, cerca del máximo de 0.05: con datos locales en el ajuste y la mitad del peso del ancla, la prevalencia se aparta del ancla, y eso es justamente lo que vigila la segunda compuerta. Banda por banda:
op <- par(mfrow = c(1, 2), mar = c(5.5, 4.5, 3, 1))
for (comprobacion in c("anchor_identity", "implied_incidence")) {
  validacion_medida <- validacion[validacion$check == comprobacion, ]
  rango <- range(validacion_medida$valor_modelo, validacion_medida$valor_gbd)
  plot(validacion_medida$valor_gbd, validacion_medida$valor_modelo, log = "xy", xlim = rango, ylim = rango,
       pch = ifelse(validacion_medida$sex_id == 1, 1, 19), xlab = "Ancla", ylab = "Modelo", sub = "Datos sintéticos",
       main = if (comprobacion == "anchor_identity") "Prevalencia" else "Incidencia implícita")
  abline(0, 1, lty = 2)
}
legend("topleft", c("hombres", "mujeres"), pch = c(1, 19), bty = "n")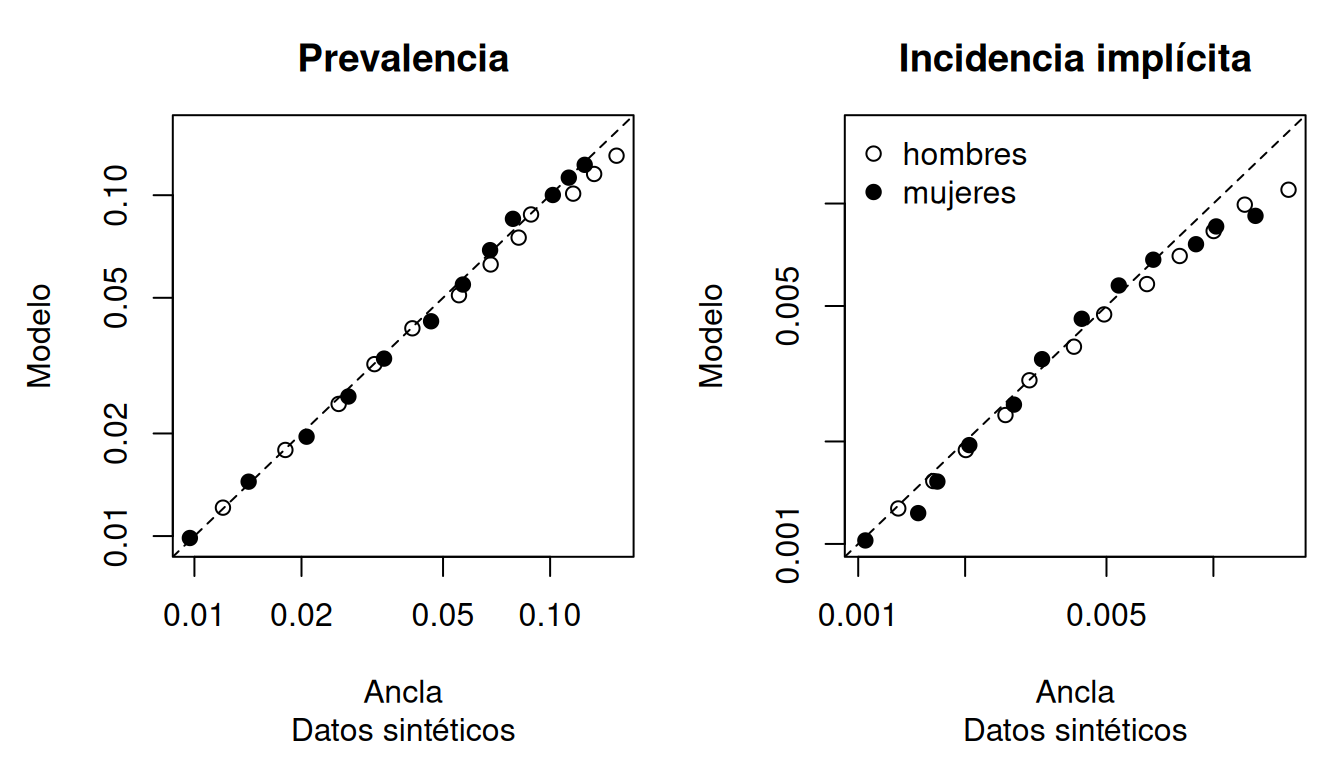
par(op)Cada punto es una banda de edad; sobre la diagonal, el modelo y el ancla coinciden. La amplitud compara, por sexo, el gradiente subnacional predicho con el observado en la mortalidad reservada, que nunca entró al ajuste:
amplitud <- attr(validacion, "amplitud")
as.data.frame(amplitud)[, c("sex_id", "kappa", "pendiente", "pendiente_lower", "pendiente_upper", "spearman",
                            "n_departamentos")]
#>   sex_id kappa pendiente pendiente_lower pendiente_upper  spearman
#> 1      1     1 0.9703236       0.8184986        1.122149 0.8141414
#> 2      2     1 1.0309071       0.9044523        1.157362 0.8141414
#>   n_departamentos
#> 1              10
#> 2              10
n_departamentos es el número de ubicaciones subnacionales con datos reservados en la comparación (un nombre de la versión 0.2.2; ver los nombres anteriores). pendiente es la de log(observado / nacional) sobre log(predicho / nacional): cerca de 1, la estimación subnacional reproduce la magnitud de las diferencias entre ubicaciones; menor que 1, las exagera; mayor que 1, se queda corta. spearman mide si ordena bien las ubicaciones. Las columnas *_std repiten el cálculo con tasas estandarizadas por edad (un punto por ubicación). La corrida guarda esta tabla en diagnostics/amplitud.csv y su resumen en el manifiesto. La guía Estimación subnacional explica κ y la estimación subnacional.
Cuánto informan los datos: las etiquetas
dl_etiquetas() compara, en cada celda (sexo y banda de edad), el ajuste con los datos locales y el ajuste solo con el ancla (dl_ajustar_solo_prior(), con la misma semilla). Con q la prevalencia de la banda:
- contracción c = 1 − Var(log q con datos) / Var(log q solo con el ancla): cuánto redujeron los datos la incertidumbre;
- desplazamiento d = |mediana(log q con datos) − mediana(log q solo con el ancla)|: cuánto movieron la estimación.
Cada celda recibe una etiqueta:
| Etiqueta | Regla | Lectura |
|---|---|---|
prior-driven |
d < 0.05 o c < 0.05 | los datos locales movieron la estimación menos de un 5 % o casi no redujeron su incertidumbre: en la práctica, es la del ancla |
prior-informed |
d >= 0.05 y 0.05 <= c < 0.3 | los datos locales movieron la estimación y redujeron algo su incertidumbre; el ancla sigue pesando |
data-driven |
d >= 0.05 y c >= 0.3 | los datos locales movieron la estimación y redujeron su incertidumbre al menos un 30 % |
c depende de la correlación por edad del ancla (ρ), así que se recalcula con cada valor de sensibilidad.correlacion_edad (por defecto 0, 0.5 y 0.9) y cada celda se queda con la etiqueta más conservadora, con el ρ que la dio (rho_usado). Las celdas subnacionales no tienen parámetros propios: heredan la etiqueta de su celda nacional.
ajuste_prior <- dl_ajustar_solo_prior(insumos, opciones, semilla = 1, ajuste = ajuste)
etiquetas <- dl_etiquetas(ajuste, ajuste_prior, insumos, semilla = 1,
                          opciones = dl_opciones_mcmc(simulaciones = 200, cadenas = 2, iteraciones = 3000,
                                                      calentamiento = 1000, nucleos = 4))
table(etiquetas$etiqueta[etiquetas$location_id == "123"])
#>
#> prior-driven
#>           24
opciones fija las cadenas de los reajustes con cada ρ (sin él, 2 cadenas de 6000 iteraciones y adelgazamiento 10). Sin datos locales en el ajuste (datos_en_ajuste vacío, como en el ejemplo sin cambios), el ajuste solo con el ancla es el mismo ajuste y todas las celdas son prior-driven.
bandas <- as.data.frame(insumos$bandas_catalogo)[, c("age_group_id", "age_start", "age_end")]
bandas$nombre <- ifelse(bandas$age_end >= 125, paste0(bandas$age_start, "+"),
                        paste0(bandas$age_start, "-", bandas$age_end - 1))
etiquetas_bandas <- merge(as.data.frame(etiquetas[etiquetas$location_id == "123", ]), bandas, by = "age_group_id")
etiquetas_bandas <- etiquetas_bandas[order(etiquetas_bandas$sex_id, etiquetas_bandas$age_start), ]
color <- c("prior-driven" = "grey70", "prior-informed" = "steelblue", "data-driven" = "darkorange")
espacios <- c(rep(0.2, sum(etiquetas_bandas$sex_id == 1)), 1, rep(0.2, sum(etiquetas_bandas$sex_id == 2) - 1))
op <- par(mar = c(5.5, 4.5, 3, 1))
centros <- barplot(etiquetas_bandas$contraccion, col = color[etiquetas_bandas$etiqueta],
                   names.arg = etiquetas_bandas$nombre, las = 2, cex.names = 0.7, ylim = c(0, 1.15), space = espacios,
                   ylab = "Contracción c", main = "Contracción por banda de edad", sub = "Datos sintéticos")
mtext(c("Hombres", "Mujeres"), side = 3, line = 0, at = tapply(centros, etiquetas_bandas$sex_id, mean))
abline(h = c(0.05, 0.3), lty = 2)
legend("top", names(color), fill = color, bty = "n", cex = 0.8, horiz = TRUE)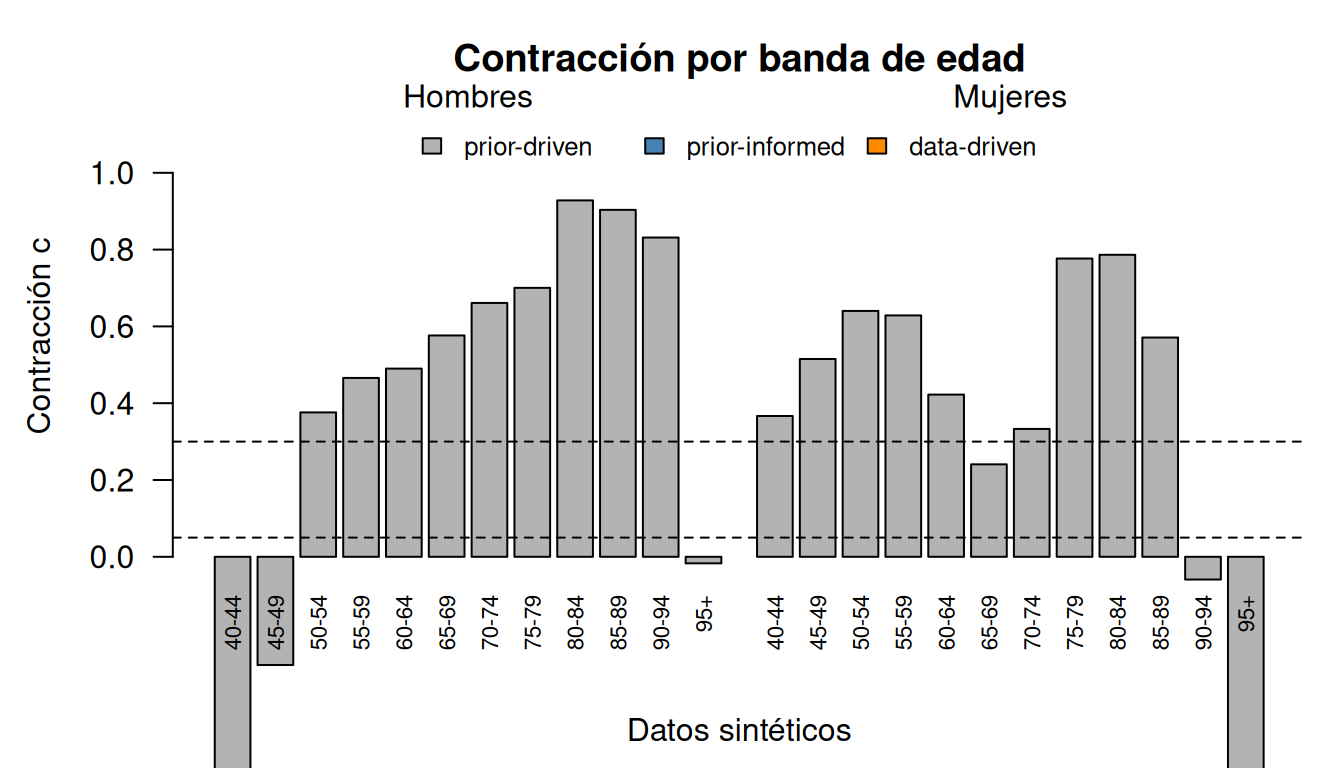
par(op)Una barra alta en gris es una celda en que los datos redujeron la incertidumbre pero movieron la mediana menos de un 5 % (d < 0.05): confirman la estimación de referencia y la etiqueta lo dice. Las etiquetas viajan con la corrida (etiquetas/) para que nadie lea como evidencia local lo que es, en realidad, la estimación de referencia.
Sin opciones (así la llama dl_correr()), los reajustes de dl_etiquetas() usan cadenas cortas con un adelgazamiento fijo de 10, sea cual sea el del ajuste, y guardan a lo sumo 600 simulaciones (y a lo sumo las del ajuste): con un ajuste de cadenas largas y un adelgazamiento mayor (por ejemplo, 30), sus cuantiles salen de más simulaciones que si heredaran ese adelgazamiento. Con opciones, usa las que se le den.
Sensibilidad a λ, ρ y κ
dl_sensibilidad() repite el ajuste en una grilla de pesos del ancla (λ, ancla.peso), correlaciones por edad (ρ, ancla.correlacion_edad) y fuerzas del efecto subnacional (κ, subnacional.kappa): un ajuste (y su ajuste solo con el ancla y sus etiquetas) por cada par (λ, ρ) y una estimación subnacional por cada κ. La grilla por defecto es la de sensibilidad en la configuración (sin ella, λ ∈ {0.25, 0.5, 1}, ρ ∈ {0, 0.5, 0.9} y κ ∈ {0.5, 1}: 9 ajustes). Aquí, una grilla pequeña con cadenas cortas, repartida en tres procesos (procesos = 3, con el mismo resultado):
sensibilidad <- dl_sensibilidad(insumos, grilla = list(lambda = c(0.25, 0.5, 1), rho = 0.5, kappa = c(0.5, 1)),
                                semilla = 1, procesos = 3,
                                opciones = dl_opciones_mcmc(simulaciones = 200, cadenas = 2, iteraciones = 3000,
                                                            calentamiento = 1000))
head(as.data.frame(sensibilidad)[, c("lambda", "rho", "kappa", "sex_id", "age_group_id", "val", "lower", "upper",
                                     "etiqueta", "dpto_min", "dpto_max")])
#>   lambda rho kappa sex_id age_group_id        val       lower      upper
#> 1   0.25 0.5   0.5      1           13 0.01299970 0.007882529 0.01799078
#> 2   0.25 0.5   0.5      1           14 0.01885164 0.013405293 0.02405476
#> 3   0.25 0.5   0.5      1           15 0.02524553 0.019395186 0.03001499
#> 4   0.25 0.5   0.5      1           16 0.03221722 0.026236254 0.03764797
#> 5   0.25 0.5   0.5      1           17 0.03989209 0.034598291 0.04481049
#> 6   0.25 0.5   0.5      1           18 0.04910010 0.043455242 0.05448267
#>       etiqueta  dpto_min dpto_max
#> 1  data-driven 0.9482501 1.084605
#> 2  data-driven 0.9525347 1.088172
#> 3  data-driven 0.9561058 1.091900
#> 4  data-driven 0.9586685 1.094358
#> 5  data-driven 0.9541579 1.097533
#> 6 prior-driven 0.9434612 1.101073
Cada fila es la prevalencia nacional de una banda con una combinación, con su etiqueta, y el abanico subnacional: dpto_min, dpto_med y dpto_max son el mínimo, la mediana y el máximo, entre las ubicaciones subnacionales, del cociente entre la prevalencia de la ubicación y la nacional. El detalle por ubicación está en attr(sensibilidad, "departamental") (nombres de la versión 0.2.2; ver los nombres anteriores).
sensibilidad_lambda <- merge(as.data.frame(sensibilidad[sensibilidad$sex_id == 2 & sensibilidad$kappa == 1, ]),
                             bandas, by = "age_group_id")
lambdas <- sort(unique(sensibilidad_lambda$lambda))
colores <- c("darkorange", "steelblue", "grey20")
op <- par(mfrow = c(1, 2), mar = c(5.5, 4.5, 3, 1))
plot(range(sensibilidad_lambda$age_start), 100 * c(0, 1.15 * max(sensibilidad_lambda$upper)), type = "n",
     xlab = "Edad (inicio de la banda)", ylab = "Prevalencia (%)", main = "Mujeres: prevalencia nacional",
     sub = "Datos sintéticos")
for (j in seq_along(lambdas)) {
  curva <- sensibilidad_lambda[sensibilidad_lambda$lambda == lambdas[j], ]
  curva <- curva[order(curva$age_start), ]
  polygon(c(curva$age_start, rev(curva$age_start)), 100 * c(curva$lower, rev(curva$upper)),
          col = adjustcolor(colores[j], 0.2), border = NA)
  lines(curva$age_start, 100 * curva$val, col = colores[j], lwd = 2)
}
legend("topleft", paste("λ =", lambdas), col = colores, lwd = 2, bty = "n")
sensibilidad_kappa <- merge(as.data.frame(sensibilidad[sensibilidad$sex_id == 2 & sensibilidad$lambda == 1, ]),
                            bandas, by = "age_group_id")
rango <- range(sensibilidad_kappa$dpto_min, sensibilidad_kappa$dpto_max)
plot(range(sensibilidad_kappa$age_start), c(rango[1], rango[2] + 0.3 * diff(rango)), type = "n",
     xlab = "Edad (inicio de la banda)", ylab = "Subnacional / nacional", main = "Abanico subnacional (λ = 1)",
     sub = "Datos sintéticos")
for (kp in c(0.5, 1)) {
  abanico <- sensibilidad_kappa[sensibilidad_kappa$kappa == kp, ]
  abanico <- abanico[order(abanico$age_start), ]
  segments(abanico$age_start + (kp - 0.75) * 2, abanico$dpto_min, abanico$age_start + (kp - 0.75) * 2,
           abanico$dpto_max, col = if (kp == 1) "grey20" else "steelblue", lwd = 3)
}
abline(h = 1, lty = 2)
legend("top", c("κ = 0.5", "κ = 1"), col = c("steelblue", "grey20"), lwd = 3, bty = "n", horiz = TRUE)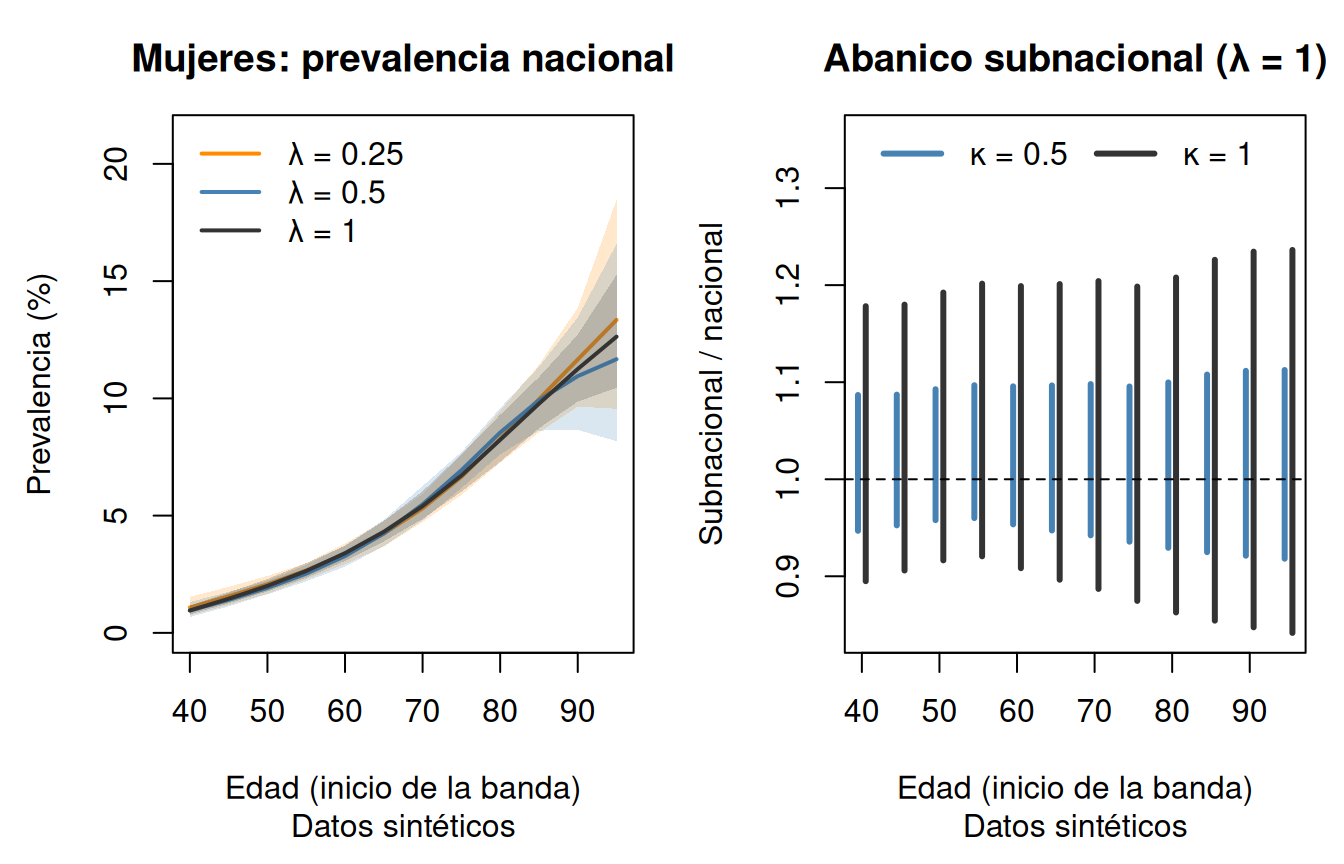
par(op)A la izquierda, λ. En el ejemplo, el ancla y los datos locales salen de las mismas curvas verdaderas y coinciden, así que λ casi no mueve la prevalencia: cambia sobre todo el ancho de su intervalo, que en promedio es menor con el ancla a peso completo (λ = 1). El ancho relativo promedio del intervalo del 95 % ((superior − inferior) / valor), por λ y sexo:
sensibilidad$ancho <- (sensibilidad$upper - sensibilidad$lower) / sensibilidad$val
aggregate(ancho ~ lambda + sex_id, data = as.data.frame(sensibilidad[sensibilidad$kappa == 1, ]), FUN = mean)
#>   lambda sex_id     ancho
#> 1   0.25      1 0.3900545
#> 2   0.50      1 0.3390448
#> 3   1.00      1 0.3199673
#> 4   0.25      2 0.3696422
#> 5   0.50      2 0.3650414
#> 6   1.00      2 0.2631540
Cuando el ancla y los datos locales no coinciden, λ decide cuál de los dos manda, y la curva se mueve. A la derecha, κ: el rango de los cocientes entre las ubicaciones subnacionales y la nación (de mínimo a máximo) se achica cuando κ baja, porque κ es la fracción del efecto de las covariables que se aplica. Una conclusión que cambia mucho dentro de la grilla depende de esa elección y conviene decirlo al publicarla. dl_correr() corre la sensibilidad con la grilla de la configuración y la guarda en diagnostics/sensibilidad.csv.
Elegir las cadenas
- Empieza con
dl_correr(rapido = TRUE)para ver que el proyecto corre de principio a fin; después, la corrida de producción. - Las cadenas de producción son las de
dl_opciones_mcmc()por defecto: 4 cadenas de 50 000 iteraciones, las primeras 10 000 de calentamiento, y se guarda una de cada 10 (adelgazamiento). Cada cadena guarda (50 000 − 10 000) / 10 = 4000 simulaciones; de las 16 000 de las cuatro cadenas se toman 1000 (simulaciones), equiespaciadas, para las tablas. En la corrida de producción del ejemplo (sin cambios), el R-hat máximo fue 1.002 y el ESS mínimo, unos 4200: holgadamente sobre las compuertas. - Si la compuerta de convergencia falla, alarga las cadenas: más
iteracionesy máscalentamiento(múltiplo de 200), por ejemplodl_opciones_mcmc(iteraciones = 100000, calentamiento = 20000), y pásalas condl_correr(opciones = ...). Más cadenas ayudan a detectar un problema, no a resolverlo. -
simulacionesno puede pasar de las que guardan las cadenas: cadenas × (iteraciones − calentamiento) / adelgazamiento. - La semilla es obligatoria: la misma semilla, con los mismos insumos y opciones, da la misma corrida. Dentro de una sesión, un ajuste idéntico se toma de la caché (
dl_limpiar_cache()la vacía).
Cuánto tarda una corrida de producción
Estos tiempos no se calculan al construir esta guía: se midieron con la corrida de producción del ejemplo (causa 9100, con la estimación subnacional y la sensibilidad),
dl_correr(dl_ejemplo(), causa = 9100, semilla = 1, carpeta_salida = "resultados", opciones = ...)en un Mac con un procesador de 10 núcleos (Apple M4, 16 GB de memoria), con otros programas en uso. Están redondeados y varían de una medición a otra; en otra computadora cambian, pero las proporciones se mantienen.
opciones |
Corrida completa |
|---|---|
NULL: motor "mh", 1 núcleo (por defecto) |
unos 5 min |
dl_opciones_mcmc(nucleos = 4) |
unos 2 min |
dl_opciones_mcmc(motor = "rcpp") |
alrededor de 1 min |
dl_opciones_mcmc(motor = "rcpp", nucleos = 4) |
alrededor de medio minuto |
Con las opciones por defecto, unos 2 minutos son de la sensibilidad. Qué se lleva el tiempo:
- El ajuste nacional: son 400 000 iteraciones (4 cadenas × 50 000 × 2 sexos) y en cada una se resuelve la ecuación del modelo para cada bloque de parámetros. Su tiempo crece con las iteraciones, las cadenas, los sexos, los nudos y las edades del modelo. Es lo que acortan
nucleosy el motor"rcpp". - La sensibilidad: un ajuste corto por cada par (λ, ρ) de la grilla (9 en el ejemplo), con su ajuste solo con el ancla si hay datos locales en el ajuste, y una estimación subnacional por cada κ. Una grilla más chica tarda menos. Usa sus propias cadenas cortas (2 cadenas de 6000 iteraciones), con el motor de las
opcionesdedl_correr()y con susnucleoscomo procesos, que reparten los pares (λ, ρ).
Cuándo usar motor = "rcpp". Es la misma log-posterior escrita en C++: en el ejemplo, la corrida pasa de unos 5 minutos a alrededor de 1, con la sensibilidad incluida, que usa el mismo motor. Conviene cuando hay muchas causas o años que correr, cadenas más largas o grillas de sensibilidad grandes. Necesita el paquete Rcpp y un compilador de C++ (Rtools en Windows; xcode-select --install en macOS; g++ en Linux); la primera vez que se usa en una computadora compila el código, y lo guarda para las sesiones siguientes. Sus resultados coinciden con los de "mh" salvo en las últimas cifras decimales, no bit a bit: por eso "mh" es el valor por defecto, y conviene no mezclar motores entre corridas que se comparan entre sí. El manifiesto registra el motor de cada corrida (params$engine).
Varios núcleos. nucleos reparte las cadenas del ajuste nacional entre procesos: con 4 cadenas y 2 sexos hay 8 tareas, así que más de 8 núcleos no lo acortan más. En la sensibilidad, los mismos nucleos reparten los pares (λ, ρ) de la grilla (9 en el ejemplo), con un núcleo por ajuste; cambian el tiempo, no los números. Funciona en macOS y Linux; en Windows se usa uno (con un aviso) y el resultado es el mismo, porque cada cadena tiene su propia semilla.
La sensibilidad por separado. Para correrla con otras cadenas, otra grilla u otro número de procesos que los de dl_correr(), arma la corrida paso a paso (ver Corridas, versiones y tablas consolidadas), corre dl_sensibilidad() con los procesos y el motor que quieras,
sensibilidad <- dl_sensibilidad(insumos, semilla = 1, procesos = 4,
                                opciones = dl_opciones_mcmc(simulaciones = 200, cadenas = 2, iteraciones = 6000,
                                                            calentamiento = 3000, motor = "rcpp"))
y pasa el resultado a dl_exportar_corrida(sensibilidad = sensibilidad).
Siguientes pasos
- Corridas, versiones y tablas consolidadas: la carpeta de una corrida, sus versiones y el consolidado.
-
Datos locales:
datos_en_ajuste, el doble conteo yancla.peso. - Estimación subnacional: κ, los proxies y la validación de amplitud.
- La ayuda:
?dl_opciones_mcmc,?dl_rhat,?dl_ess,?dl_validar_ancla,?dl_etiquetas,?dl_sensibilidad.